Erstellen
Ein Frontiermodell baut die Arbeitsumgebung und Tools.
WOCHE 04
KI & DATA SCIENCE · WOCHE 04
Agenten, Harnesses und Werkstätten · Prof. Dr. Mathias Engel
Zeitfenster: 0–5 Minuten seit Beginn · Einstieg
An W03 anknüpfen: Damals lief der Eventplaner ohne Modell. Heute arbeitet ein Modell während des Auftrags mit Werkzeugen. Der Maßstab ist nicht eine schöne Oberfläche, sondern nachgewiesene Leistung unter Regeln.
WOCHE 04
Drei verschiedene Bausteine:
Modell: verarbeitet Kontext und erzeugt Text oder Tool-Aufrufe.
Harness: organisiert Ausführung, Kontext, Rechte, Schleifen und Protokolle, z. B. Codex.
Werkzeuge: konkrete Funktionen, z. B. Python-Kostenrechnung oder SQLite-Abfrage.
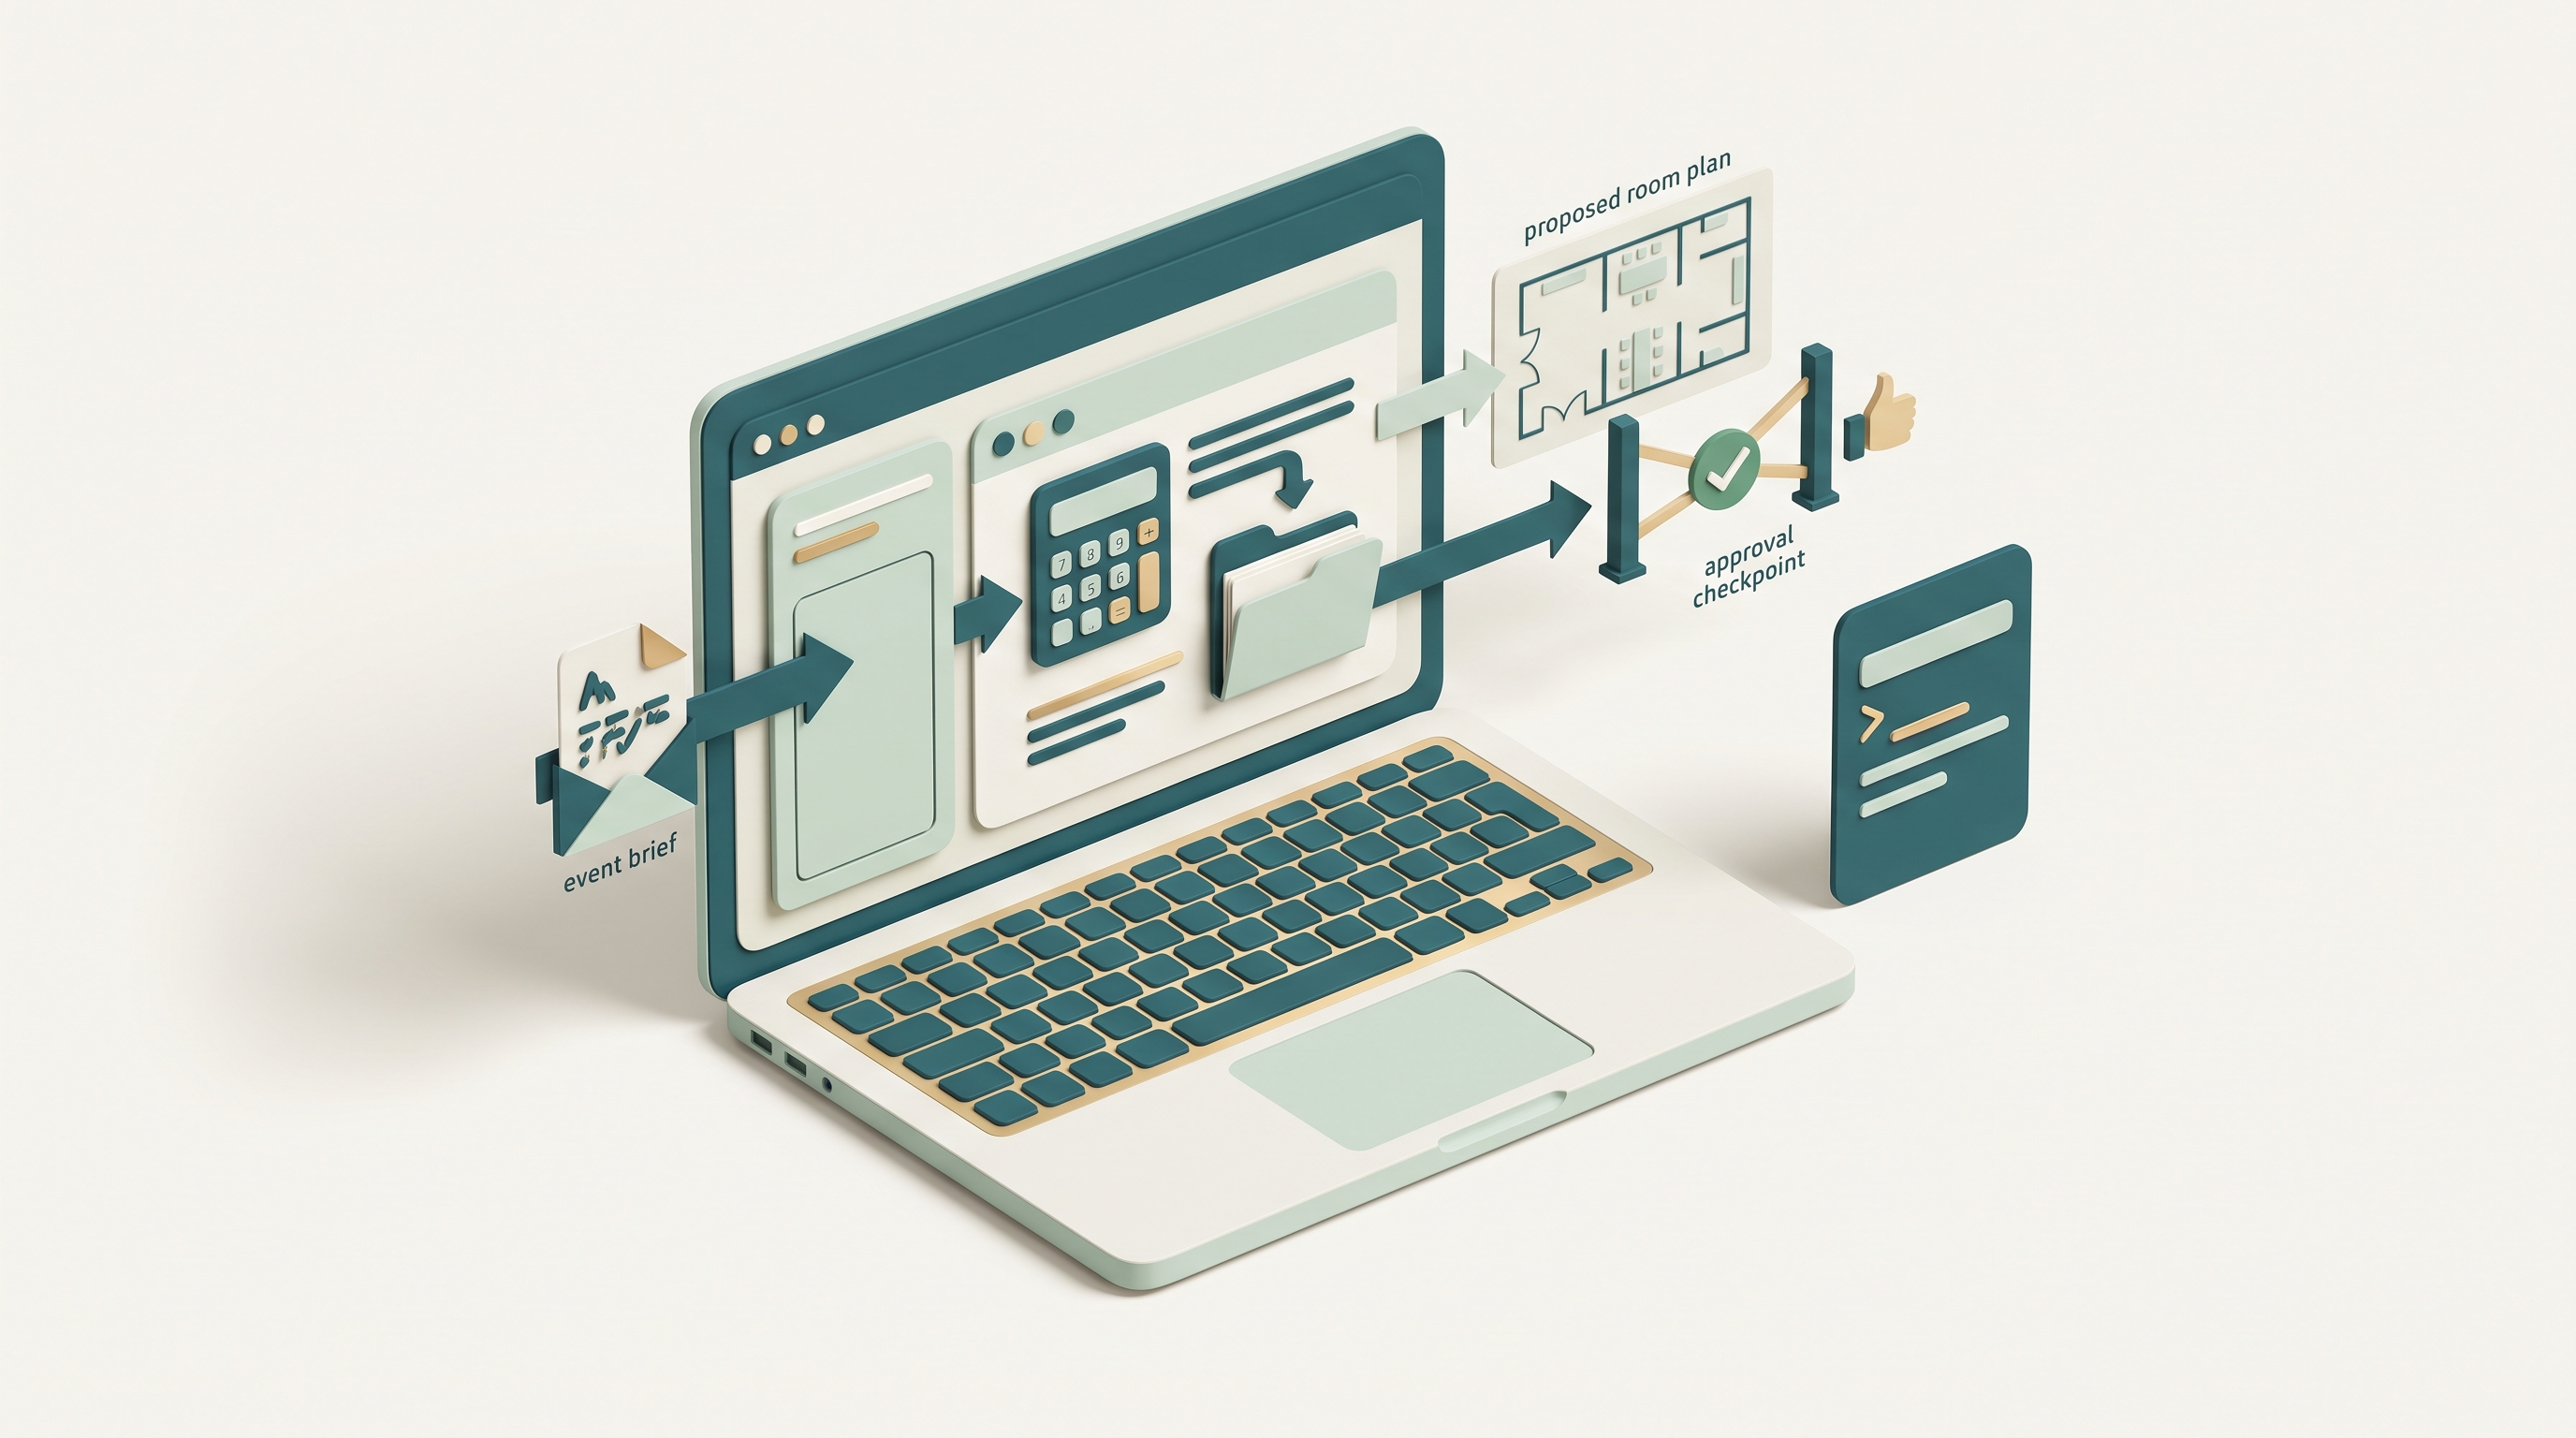
Zeitfenster: 5–17 Minuten seit Beginn · Modell / Harness / Mitarbeiter
Die Fachkraft-/Arbeitsplatzmetapher hat Grenzen. Das Modell ist keine Person; der Harness ist Laufzeitsoftware. Technische Berechtigungen müssen im System umgesetzt werden, nicht nur im Rollenprompt. Anthropic liefert ein Herstellerbeispiel, keinen universellen Standard.
WOCHE 04
1 · Auftrag
Was genau soll erledigt werden?
2 · Skills
Erlernte Vorgehensweisen für Teilaufgaben.
3 · Tools
Deterministische Mess-/Prüfwerkzeuge.
4 · Memory
Persistentes Wissen; passend abrufen.
5 · Pensum
Zeit-, Schritt- und Kostenbudget.
6 · Kognitive Grenzen
Modellfähigkeit und aktiver Kontext.
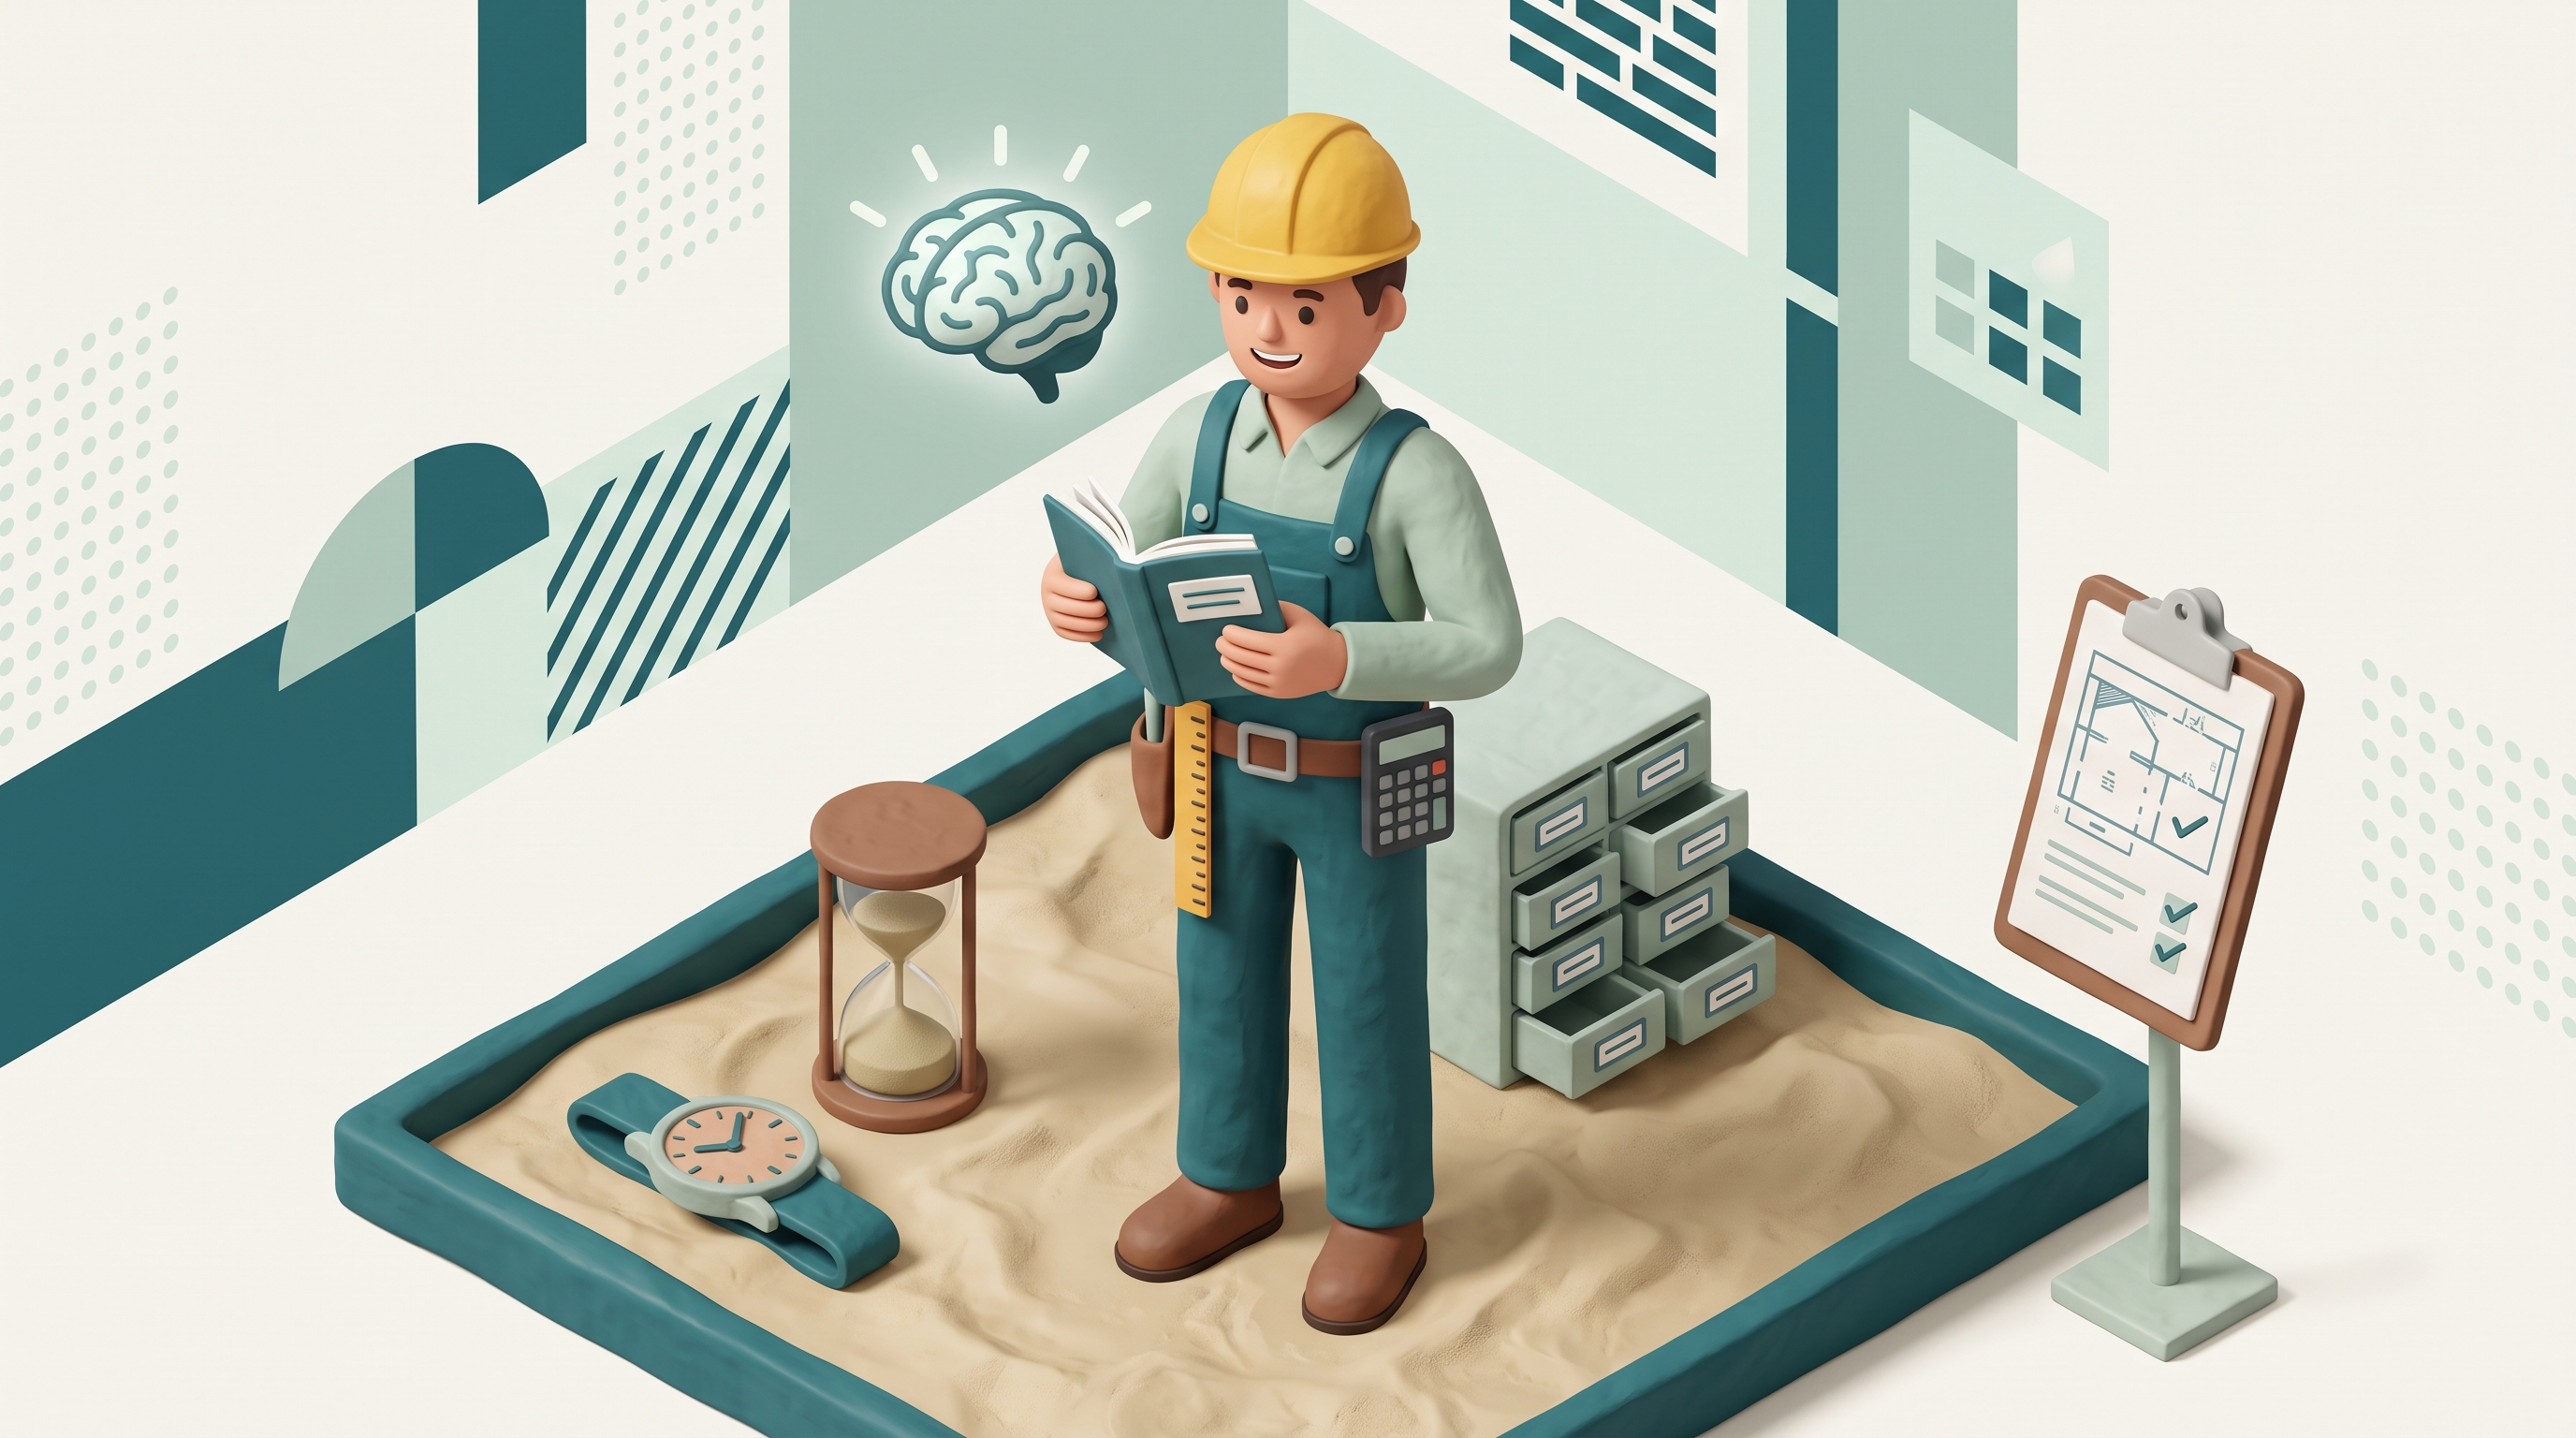 1 Auftrag2 Skills3 Tools4 Memory5 Pensum6 Grenzen
Zeitfenster: 5–17 Minuten seit Beginn · Modell / Harness / Mitarbeiter
Zeigen Sie sechs Dateien als Mitarbeiterakte, ohne Dateiformate ausführlich zu lehren. Die Funktionsaufteilung ist wichtiger als ein starres Zeichenlimit. Die gefundene September-Arbeit wird eng eingeordnet: Codebeschreibungen statt allgemeiner AGENTS.md-Schwelle.
WOCHE 04
BUILD & CHECK
Frontier baut — Mini führt später aus
Eigene Arbeitskopie mit den fiktiven Eventdaten anlegen.
Mitarbeiterakte, Tools und Memory bauen lassen; direkt in Codex starten.
Gegenprobe: Funktioniert derselbe Prüfauftrag ganz ohne UI?
Zeitfenster: 17–45 Minuten seit Beginn · Bau mit Newsflash und Wrap-up
Minute 17–20: Frontier-Bau starten und Zugänge prüfen. Minute 20–28: Newsflash zur letzten Woche, solange die Generierung läuft. Minute 28–40: Ergebnis öffnen, kurzen E01-Auftrag ohne UI ausführen, tatsächliche Tools zeigen. Bei Setup-Problemen Briefing verkürzen, Referenzpaket als Rückfallweg anbieten. Der ZIP-Stand ist eine vorbereitete Vorlage, nicht studentisch generierter Code.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Was wurde wirklich ausgeführt?
Zeigt Auftrag, Toolaufruf und konkreten Befund.
Codex ist der Harness; Python prüft deterministisch. Die UI ist optional. Eine Ergebnisanzeige allein beweist weder LLM-Nutzung noch tatsächliche Werkzeugausführung.Zielerkenntnis aufklappen
Zeitfenster: 17–45 Minuten seit Beginn · Bau mit Newsflash und Wrap-up
Fünf Minuten, einen echten Lauf auswählen. Wenn nur eine Vorlage geöffnet wurde, das transparent sagen. Keine UI-Demo als Agentenlauf verkaufen.
WOCHE 04
Speichern allein ist noch kein Erinnern.
Worker, Werkstatt und Projekt haben unterschiedliche Wissensbereiche.
Nur relevantes, bestätigtes Wissen gehört in den aktuellen Auftrag.
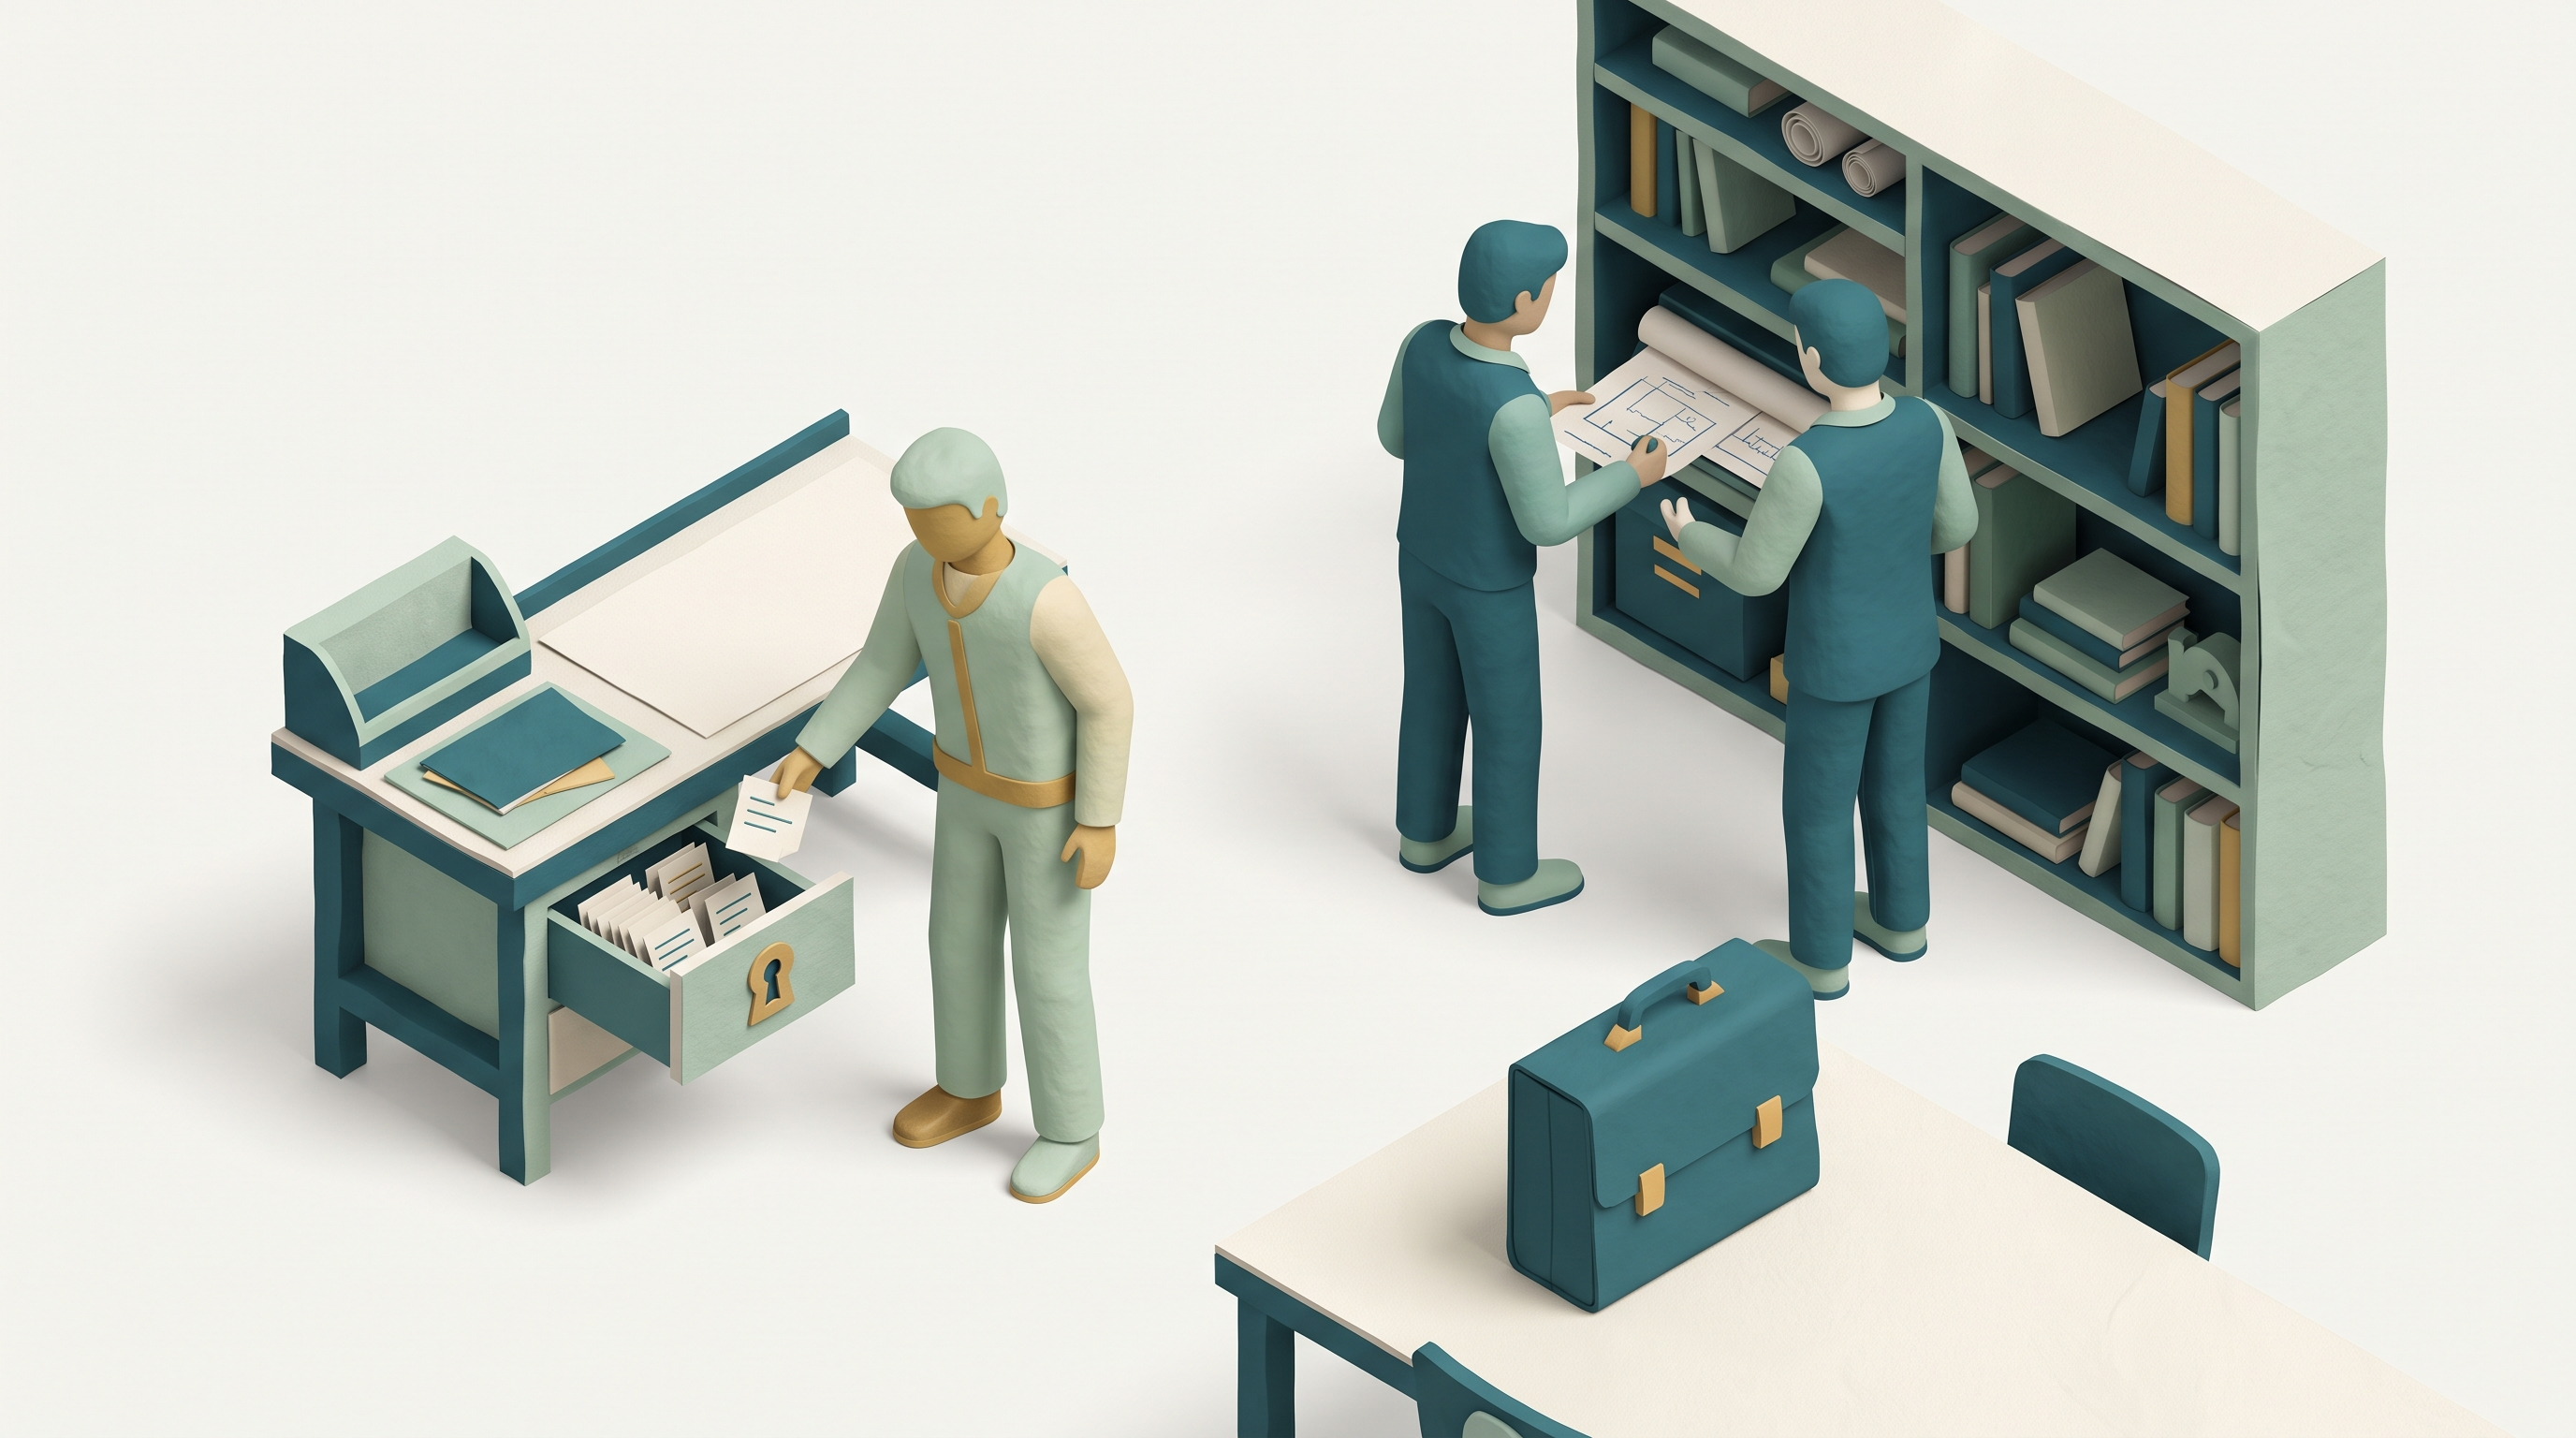
Zeitfenster: 45–60 Minuten seit Beginn · Memory und Dokumente
Erklären Sie am Budget: eine bestätigte Korrektur wird gespeichert und beim nächsten Auftrag gezielt abgerufen. SQLite ist Speichertechnik, kein automatisches Lernen. Namensräume sind logische Trennung, keine vollständige Sicherheits-Sandbox.
WOCHE 04
BUILD & CHECK
Korrigiere eine Vorgabe — und prüfe erneut
Menschlich bestätigte Budgetkorrektur in P01 auf 500 setzen.
P01 und ein anderes Projekt mit sauberem Ausgangszustand vergleichen.
Gegenprobe: Wird die Änderung gespeichert UND tatsächlich abgerufen?
Zeitfenster: 45–60 Minuten seit Beginn · Memory und Dokumente
Verwenden Sie eine Übungskopie. Die Budgetkorrektur ist ein bewusster menschlicher Befehl. Im P01-Lauf bleibt die Rechnung 520 EUR, nun 20 EUR über Budget. P02 ohne eigene Korrektur nutzt 600 EUR. Keine echten Memory-Dateien löschen.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Welcher Nachweis zeigt echtes Wiederverwenden?
Zeigt gespeicherten Wert, Toolbefund und nächsten Auftrag.
Ein gespeicherter Datensatz, ein sichtbarer Abruf und ein passender Ergebnisunterschied belegen mehr als die Aussage „Ich merke mir das“.Zielerkenntnis aufklappen
Zeitfenster: 45–60 Minuten seit Beginn · Memory und Dokumente
Fünf Minuten. Wenn P01/P02 getrennt wurden, dennoch die Grenze erläutern: Ein allgemeiner Coding-Harness mit Dateizugriff wird durch SQL-Namensräume allein nicht sicher. Die Testumgebung enthält nur synthetische Daten.
WOCHE 04
Ein guter Lauf ist keine allgemeine Freigabe.
Technik, Inhalt, Quellen, Memory, HITL und Robustheit getrennt prüfen.
Jede Agenten-/Modellkombination braucht ihren eigenen Nachweis.
Zeitfenster: 60–75 Minuten seit Beginn · Unterrichtsbenchmark / Baseline
Die sechs Unterrichtsfälle und die erweiterte 30er-Suite sind didaktische Testsuiten, kein allgemeines wissenschaftliches Minimum. Vor produktiver Nutzung zusätzliche risikogerechte und unbekannte Transferfälle vorsehen. Ein schöner Gesamtscore darf kritische Verstöße nicht verstecken.
WOCHE 04
BUILD & CHECK
Erst messen, noch nicht reparieren
v0, tatsächliches Modell und Konfiguration benennen.
T01/T03 und D02 ausführen; Befunde im Cockpit festhalten.
Gegenprobe: Unbekannte Messwerte bleiben leer, nicht null.
Zeitfenster: 60–75 Minuten seit Beginn · Unterrichtsbenchmark / Baseline
Zuerst nur T03 und D02. Die verbleibenden vier Fälle werden später verteilt nach Station ergänzt, nicht als Pflichtmatrix mit allen Modellen auf einmal.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Was ist schon belegt — was noch ungeprüft?
Nennt einen geprüften Fall und eine offene Unsicherheit.
Testabdeckung und tatsächliche Nachweise gehören zum Ergebnis. Drei bestandene Fälle sind nicht gleich dreißig bestandene Fälle; fehlende Messung ist keine Null.Zielerkenntnis aufklappen
Zeitfenster: 60–75 Minuten seit Beginn · Unterrichtsbenchmark / Baseline
Fünf Minuten, Rohdatenstand als JSON exportieren lassen. Der spätere Vergleich braucht die Ausgangsversion und identische Bedingungen. Nicht nur den erfolgreichsten Einzellauf merken.
WOCHE 04
BUILD & CHECK
Teste die Grenzen, nicht nur den Normalfall
Kapazitätsfehler, fehlendes Budget und unzulässige Buchung prüfen.
Manipulative Anweisung als untrusted Dokumentdaten einspeisen.
Gegenprobe: Wurde die unzulässige Aktion tatsächlich verhindert?
Zeitfenster: 90–120 Minuten seit Beginn · Härtetests und Optimierung
Zehn Minuten. Für die Injection ein ungefährliches fiktives Dokument verwenden. Keine realen Konten oder Rechte zum Demonstrieren anbinden. Fragen Sie nach Tool-/Systemverhalten, nicht nur nach einer höflichen Ablehnungsformulierung.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Wo liegt die Ursache des Fehlers?
Ordnet einen reproduzierbaren Befund einer Komponente zu.
Datenproblem, Modellfehler, fehlender Toolcheck und fehlende Berechtigung sind verschiedene Ursachen. Die richtige Gegenmaßnahme sitzt nicht immer im Prompt.Zielerkenntnis aufklappen
Zeitfenster: 90–120 Minuten seit Beginn · Härtetests und Optimierung
Fünf Minuten. Eine verlorene Memory-Korrektur kann Abruflogik sein; falsche Summen gehören in ein Rechentool; unzulässige Aktion braucht Systemkontrolle. Keine pauschale Forderung nach längeren Anweisungen.
WOCHE 04
BUILD & CHECK
Verbessere die Arbeitsumgebung gezielt
Fehlerbericht an Frontiermodell geben, v1 getrennt sichern.
Gleiche Tests im selben Laufzeitmodell erneut ausführen.
Gegenprobe: Wurde nur der Prompt verändert — oder auch Tool/Daten/Modell?
Zeitfenster: 90–120 Minuten seit Beginn · Härtetests und Optimierung
Zehn Minuten für eine gezielte Verbesserung. Falls sich mehrere Komponenten ändern, das protokollieren und keine isolierte Kausalwirkung behaupten. Das Baumodell darf nicht heimlich die Ausführung übernehmen.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Welche Verbesserung hält einer Wiederholung stand?
Zeigt denselben Fall mit v0 und v1.
Versionierung macht Veränderungen sichtbar. Der Vorher/Nachher-Vergleich ist nur bei vergleichbaren Fällen, Daten, Memory und Modellbedingungen aussagekräftig.Zielerkenntnis aufklappen
Zeitfenster: 90–120 Minuten seit Beginn · Härtetests und Optimierung
Fünf Minuten. Ein Mini-Modell kann durch bessere Tools profitieren; das ist eine zu prüfende Hypothese, keine garantierte Wirkung. Auch neue Regressionen zeigen.
WOCHE 04
BUILD & CHECK
Vergleiche Versionen und Modelle anhand echter Läufe
Kernfälle verteilt ausführen und Nachweise protokollieren.
Kategorieprofil und Aufwand im Cockpit gegenüberstellen.
Gegenprobe: Verschiedene Fallabdeckung oder Datenstände nicht als Modellgewinn ausgeben.
Zeitfenster: 120–145 Minuten seit Beginn · Begrenzter Modell-/Versionsvergleich
15 Minuten praktische Gegenüberstellung. Bei knapper Laufzeit nur eine Teilmenge live; vollständige Suite und Wiederholungen später. Das Cockpit zeigt aktive Läufe der geladenen Suite. Nicht anwendbare oder fehlende Messwerte begründet kennzeichnen.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Freigeben, verbessern oder nur begrenzt einsetzen?
Begründet die Entscheidung mit zwei Nachweisen und einer Grenze.
Menschliche Abnahme verbindet Qualität, Grenzen und Aufwand. Kritische Regelverstöße bleiben Stoppsignale, auch wenn andere Fälle gut aussehen. Ein leerer Messwert ist keine Kostenersparnis.Zielerkenntnis aufklappen
Zeitfenster: 120–145 Minuten seit Beginn · Begrenzter Modell-/Versionsvergleich
Fünf Minuten. Zeigen Sie, dass Kosten pro korrekt und regelkonform gelöstem Fall auch Fehlversuche berücksichtigen. Unter allen Umständen bleiben Buchungen/Versand in dieser Vorlage technisch nicht implementiert.
WOCHE 04
Werkstatt = Rollen + Übergaben + gemeinsames Projektwissen.
Planer liefert Vorschlag und Quellen.
Prüfer liefert nachvollziehbare Einwände; eigene Memories bleiben getrennt. Trinity-Bauvorlage ↗
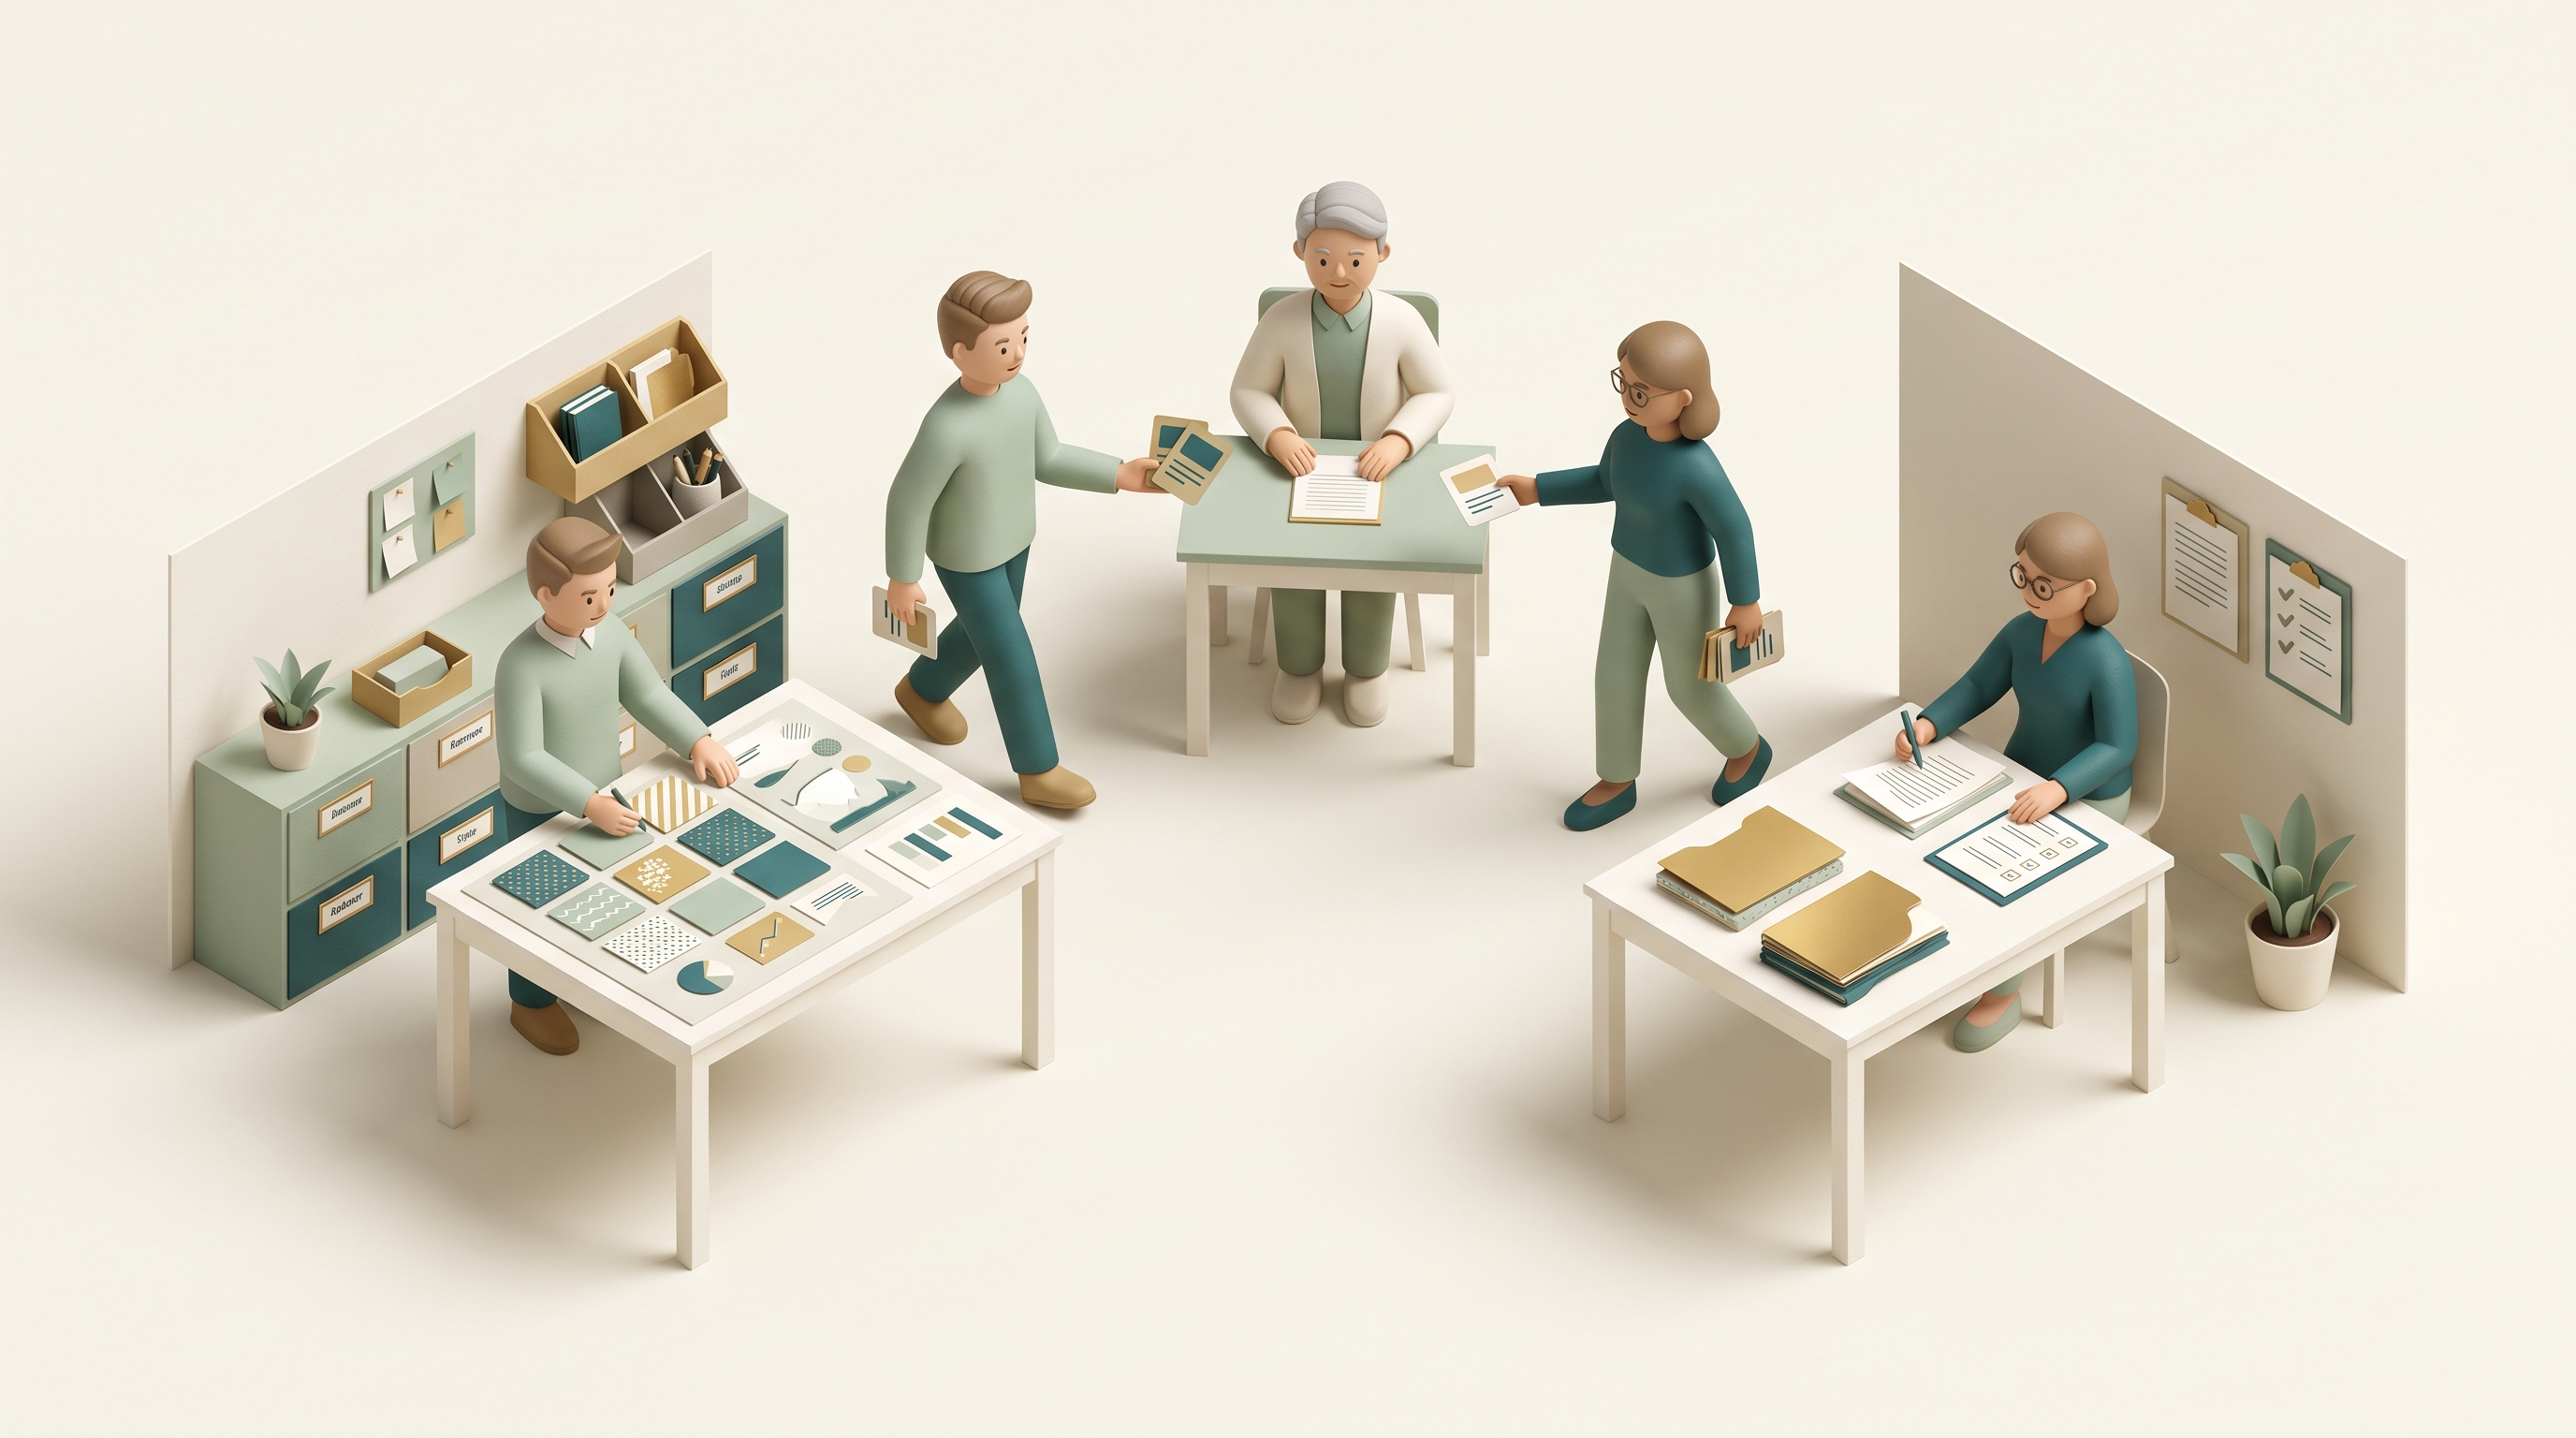
Zeitfenster: 145–155 Minuten seit Beginn · Werkstatt und Klinik-Konzil
Zwei Rollen reichen zur Erklärung. Ein fester Ablauf kann als deterministischer Workflow organisiert sein; nicht jede Übergabe braucht eine freie Agentenentscheidung. Der Bonus darf die geprüfte Kernarbeit nicht verdrängen. Die Trinity-Seite ist eine Projektvorlage, keine wissenschaftliche Validierung jeder dortigen Behauptung.
WOCHE 04
Wie eine Fallkonferenz im Krankenhaus.
Radiologie, Innere Medizin und Chirurgie bringen unterschiedliche Befunde und Fachsichten ein.
Erst getrennte Einschätzungen, dann Widersprüche klären; verantwortliche Menschen entscheiden.
Für Agenten: Planer, Budget- und Regelprüfer. Konzil bei Konflikten/hohem Risiko, nicht bei jedem Routinefall.
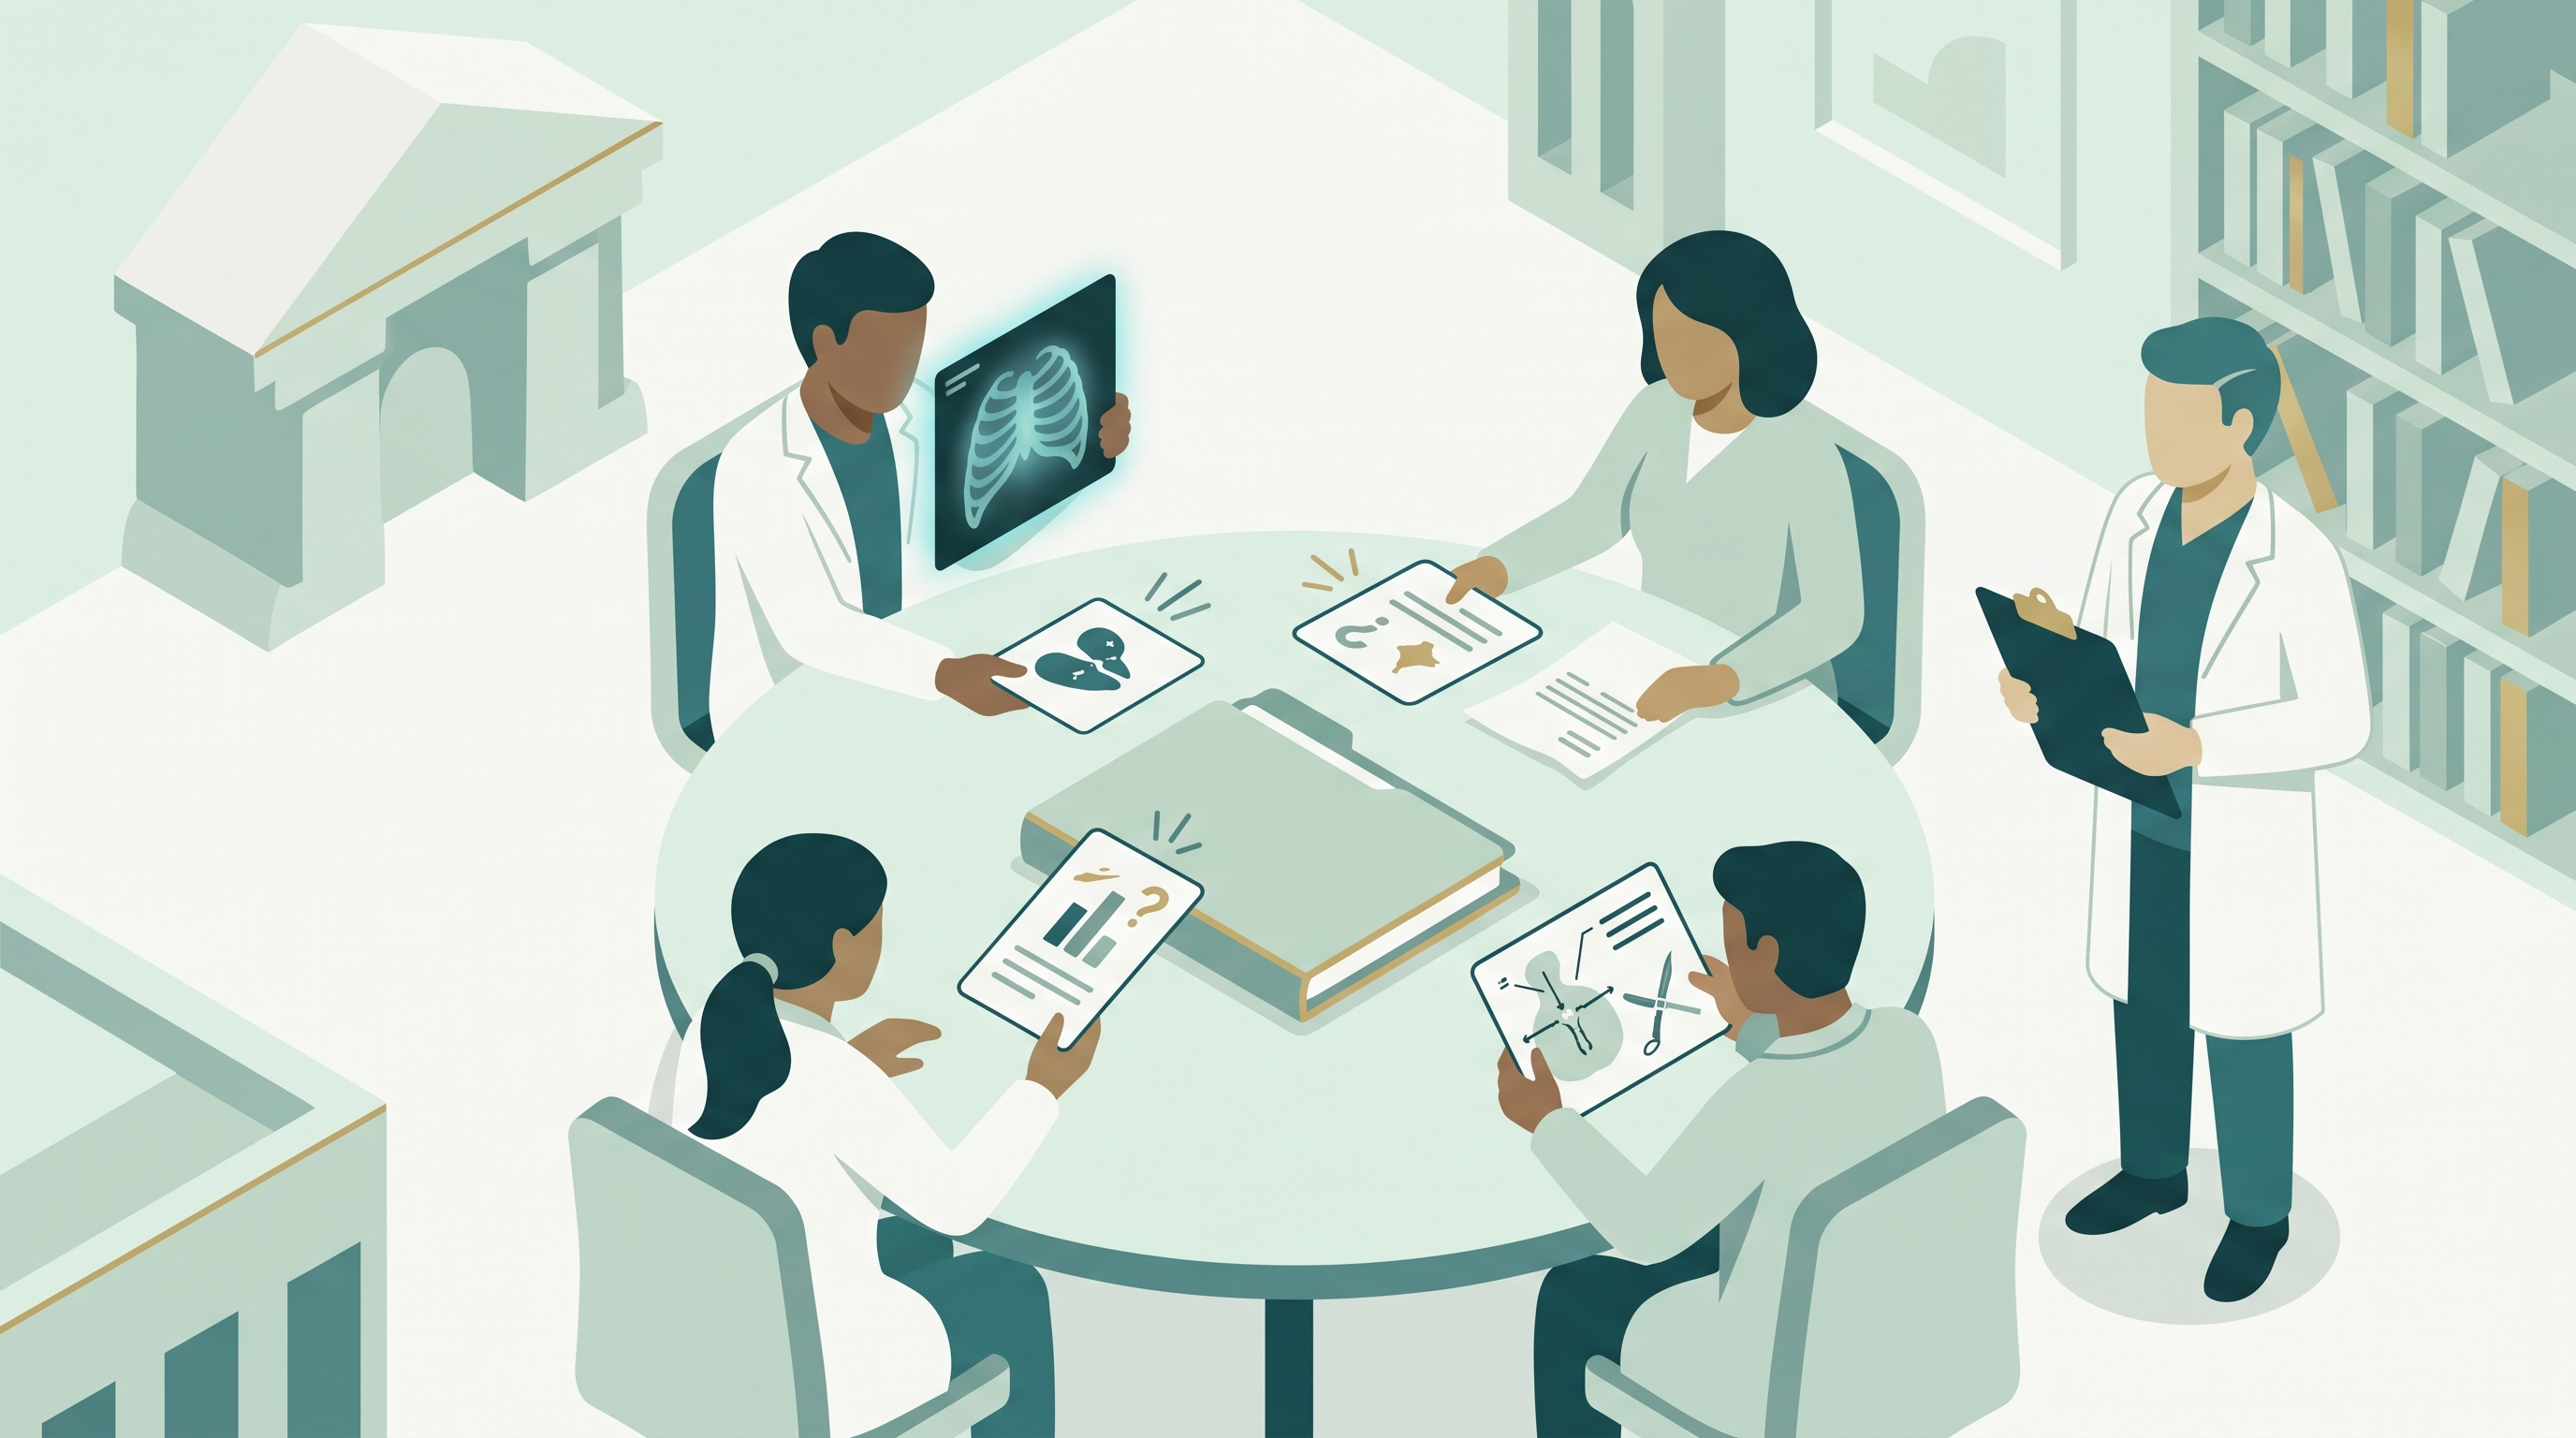
Zeitfenster: 145–155 Minuten seit Beginn · Werkstatt und Klinik-Konzil
Keine Diagnose oder Behandlung lehren. Organisationsmetapher: verschiedene Fachgebiete erweitern den Blick. Ein LLM-as-a-Judge kann Rubriken prüfen, bleibt aber fehlbar. Unabhängige Ersturteile und Quellen verlangen; gleiche Modellfehler können sich wiederholen. Einigkeit ist keine Wahrheit.
WOCHE 04
BUILD & CHECK
Ergänze einen zweiten Mitarbeiter
Nur einen Fall mit klarer Übergabe bearbeiten.
Bei knapper Zeit vorbereitete Rollenaufträge demonstrieren.
Gegenprobe: Der neue Prüfer ist ohne eigene Tests noch nicht freigegeben.
Zeitfenster: 145–155 Minuten seit Beginn · Werkstatt und Klinik-Konzil
Optionaler kurzer Bonus. Der gesamte Werkstattblock dauert zehn Minuten, also kein vollständiger neuer Agentenbau. Wenn der erste Benchmark noch unklar ist, nur das Übergabekonzept zeigen und die Übung als Vertiefung ausgeben.
WOCHE 04
WRAP-UP · GEMEINSAM BEGRÜNDEN
Was verbessert Zusammenarbeit — und was bleibt offen?
Nennt einen Nutzen und eine neue Fehlerquelle.
Arbeitsteilung braucht klare Daten, Werkzeuge, Übergaben und Verantwortung. Mehr Rollen sind nicht automatisch besser. Der Bonusagent ist noch nicht produktiv abgenommen.Zielerkenntnis aufklappen
Zeitfenster: 145–155 Minuten seit Beginn · Werkstatt und Klinik-Konzil
Drei Minuten im Bonusblock. Den ungeprüften Status des neuen Workers ausdrücklich nennen. Keine Abnahme des ersten Mitarbeiters auf das gesamte System übertragen.
WOCHE 04
Das Werkzeug bleibt — die Modellanbindung kann wechseln.
Ollama → Apps → Claude am vorbereiteten Mac.
Modell wählen, Neustart und tatsächliche Verbindung prüfen. Codex ohne UI bleibt ein separater Weg.
Zeitfenster: 155–175 Minuten seit Beginn · Lokaler Ausblick
Minute 163–170: Vorab geprüfte Verbindung zeigen, nicht erstmals im Kurs installieren. Ollama-Modell im Claude-Werkzeug ist nicht automatisch ein Anthropic-Modell. Claude Desktop von Claude Code und Codex unterscheiden; Rechte und Toolfähigkeiten gesondert prüfen.
WOCHE 04
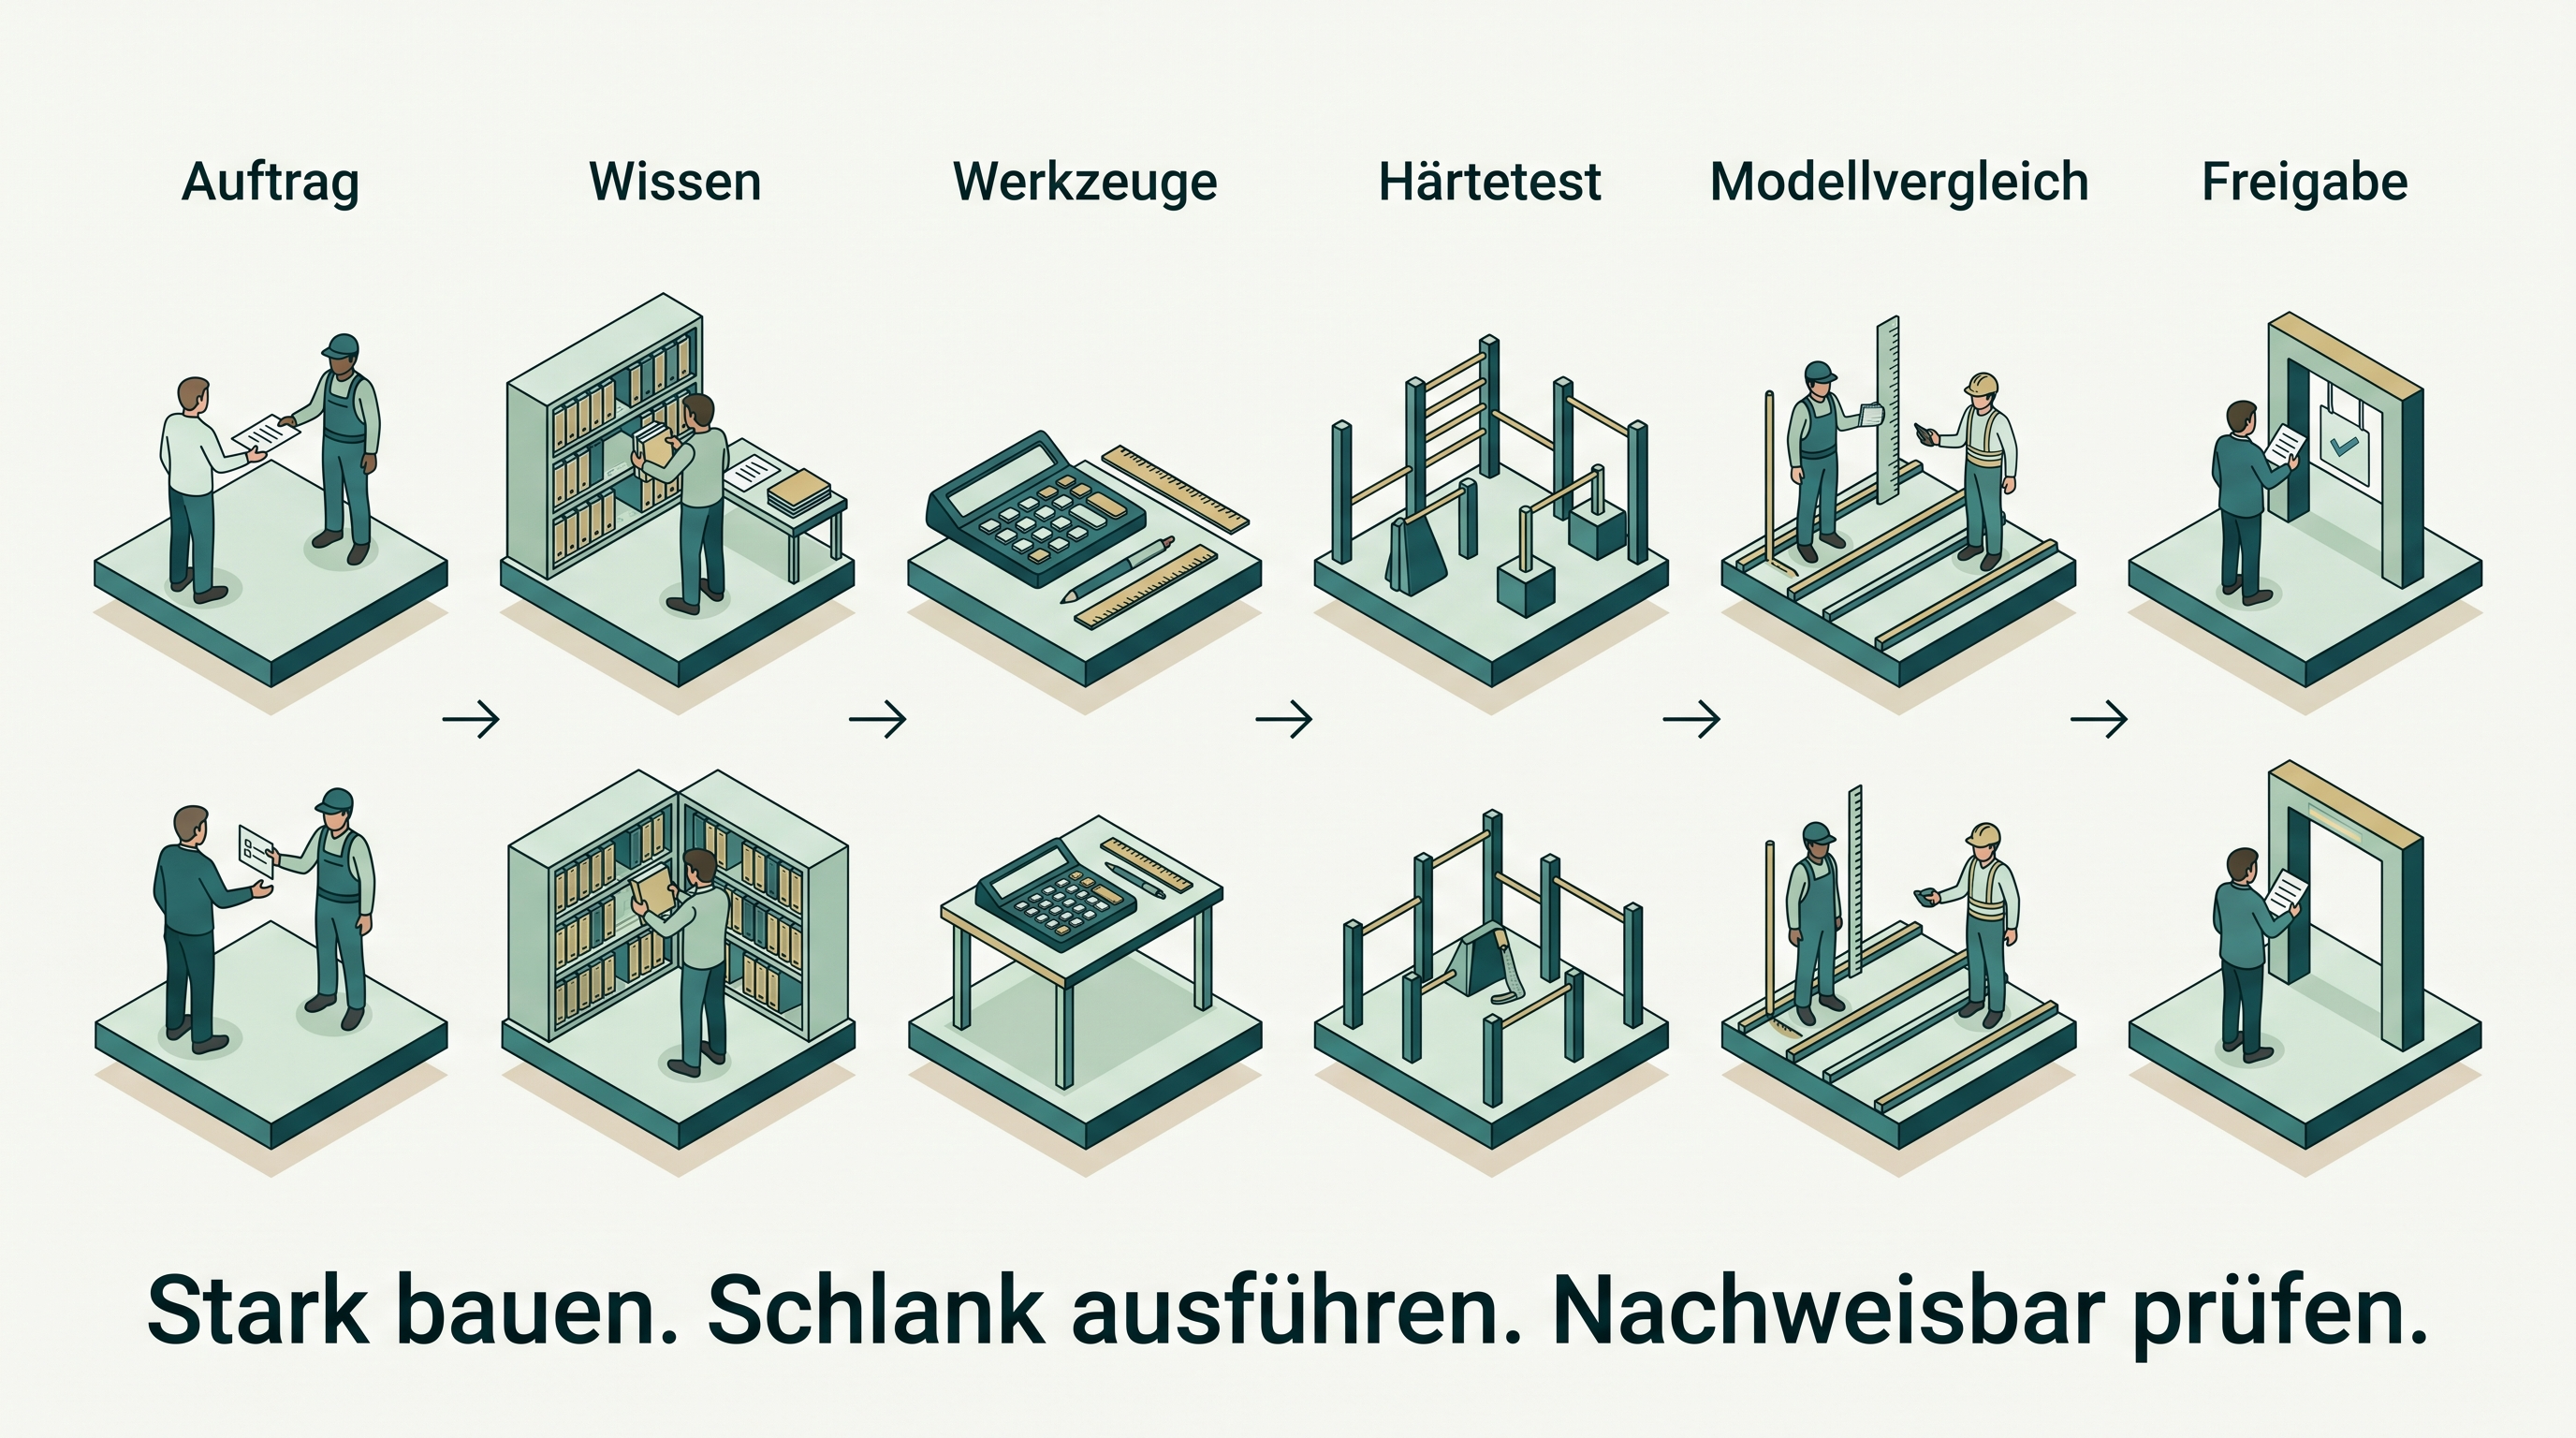
Zeitfenster: 175–180 Minuten seit Beginn · Big Picture / Quellen
Initialfrage beantworten: Vertrauen entsteht aus begrenztem Auftrag, passenden Tools, nachvollziehbarem Wissen und bestandenen, wiederholten Prüfungen. Der Bonusagent ist nicht vom Freigabestatus des ersten Mitarbeiters abgedeckt.
Md Shohel Arman; Igor Molybog · 2026 · Abruf 2026-10-19
Vollständigkeit statt zusätzlicher Ausführlichkeit; kein Beleg einer universellen 1600-Zeichen-Grenze für AGENTS.md.
preprint; Volltext Abschnitt 3.3/Tabelle 2 geprüft; begrenzte Übertragbarkeit
https://arxiv.org/html/2609.31587v1
Ollama · 2026 · Abruf 2026-10-19
Ollama-Anbindung für Claude Desktop auf macOS über Apps; Modellwechsel mit Neustart; Windows laut Dokumentation noch ausstehend.
official; HTML und Markdown geprüft; nicht lokal funktional getestet
https://docs.ollama.com/integrations/claude-desktop
Ollama · 2026 · Abruf 2026-10-19
Kontextgröße in der App einstellbar; größere Kontexte benötigen mehr Speicher.
official; Markdown geprüft
https://docs.ollama.com/context-length
Ollama · 2026 · Abruf 2026-10-19
Parameter unter anderem temperature und num_ctx über Modelfile konfigurierbar; konkrete Modellunterstützung testen.
official; Markdown geprüft
https://docs.ollama.com/modelfile
Ollama · 2026 · Abruf 2026-10-19
Externer Websuchdienst; API-Zugang mit Ollama-Konto und API-Key. Zugangsdaten nie öffentlich einbetten.
official; HTML und Markdown geprüft
https://docs.ollama.com/capabilities/web-search
Ollama · 2026 · Abruf 2026-10-19
Cloudmodelle benötigen keinen Modelldownload; Anmeldung/Zugangsbedingungen beachten. Cloud verarbeitet Anfragen extern.
official; HTML geprüft
https://docs.ollama.com/cloud
Ollama · 2026 · Abruf 2026-10-19
Dokumentierter Ollama-Anbindungsweg für Codex CLI; nicht pauschal als Desktop-App-Anleitung darstellen.
official; HTML geprüft
https://docs.ollama.com/integrations/codex
OpenAI · 2026 · Abruf 2026-10-19
Offizielle Referenz für Codex-Konfiguration; ergänzt produktspezifische Ollama-Anleitung, keine Bestätigung identischer Funktionen aller Oberflächen.
official; Weiterleitung von developers.openai.com/codex/config-reference geöffnet
https://learn.chatgpt.com/docs/config-file/config-reference
Artificial Analysis · 2026 · Abruf 2026-10-19
Hardware-/Inferenzvergleich über wiedergegebene Agententrajektorien; nicht gleichzusetzen mit fachlichem Agenten-Erfolg oder eigenem HITL-Test.
primary benchmark publisher; Methodik geprüft
https://artificialanalysis.ai/articles/aa-agentperf-local/
Artificial Analysis · 2026 · Abruf 2026-10-19
Orientierung zu dokumentierten Hardware-/Modellkombinationen; keine pauschale Best-in-Class-Aussage für beliebige Studierendenhardware.
primary benchmark publisher; Seite geöffnet; dynamische Ergebnisse vor Vorlesung erneut prüfen
https://artificialanalysis.ai/hardware-inference-stack/laptops-workstations
OpenAI · 2026 · Abruf 2026-10-19
Modellwahl in Work/Codex abhängig von Konto und Client; konkrete Luna-/Sol-Verfügbarkeit vor Demo prüfen.
official; im vorangegangenen Planungslauf geöffnet/geprüft; Zugang vor Sitzung prüfen
https://learn.chatgpt.com/docs/models
Anthropic · 2026 · Abruf 2026-10-19
Herstellerbeispiel zur Trennung von Harness, Ausführungsumgebung und Sitzungszustand; keine allgemeine Norm.
official; im vorangegangenen Recherchelauf geöffnet/geprüft
https://www.anthropic.com/engineering/managed-agents
DKFZ / Krebsinformationsdienst · 2026 · Abruf 2026-10-19
Fachübergreifende Fallkonferenz als Organisationsmetapher. Kein medizinischer Rat und kein Beleg, dass LLM-Mehrheitsentscheidungen verlässlich wären.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://www.krebsinformationsdienst.de/arzt-und-kliniksuche
Kurskonzeption nach Nutzerauftrag · 2026 · Abruf 2026-10-19
Fiktive Preise, Regeln, Testfälle und geplante Bewertung; kein wissenschaftlicher Sicherheitsindex.
Eigene synthetische Lehrdaten; technische Referenzprüfung, keine empirischen LLM-Ergebnisse
Prof. Dr. Mathias Engel / Trinity-Projekt · 2026 · Abruf 2026-10-19
Kompakte Rolle, separate Governance/Tools/Schemata, SQLite-Memory und Feedback als Projektarchitektur. 1600-Zeichen-Schwelle nicht aus Lost-in-the-Middle ableiten; technische Kontrollen müssen implementiert sein.
Projektseite und aktuelle Repository-Fassung gelesen; Architekturreferenz, nicht allgemeiner wissenschaftlicher Beleg
https://profengel.github.io/KI-Literacy/trinity-agenten.html
Kie.ai / Nano Banana 2 nach Kursauftrag · 2026 · Abruf 2026-10-19
Symbolische Anschauung, keine empirische Modellmessung.
Tatsächlich generierte Bilddateien; Provider und Prompts im Medienmanifest
Artificial Analysis · 2026 · Abruf 2026-10-19
Gewichtung Intelligence/Speed/Cost, Anforderungen und agentische Fähigkeiten; Hardwarepassung zusätzlich prüfen.
Webseite und Auswahlstufen im Browser am 19.10.2026 geprüft; dynamisch, keine eingefrorene Siegerliste
https://artificialanalysis.ai/models/recommend
OpenAI · 2026 · Abruf 2026-10-19
Dokumentierter CLI-/JSON-Ausführungsweg; konkrete Konto- und Modellverfügbarkeit vor Live-Demo prüfen.
Offizielle Dokumentation am 19.10.2026 geöffnet/geprüft
https://learn.chatgpt.com/docs/cli/reference
17–20 Startcheck · 20–28 Newsflash · 28–40 Ergebnis und UI-freien Auftrag prüfen · 40–45 Wrap-up. Bei Problemen News kürzen. Zweitagent-Bonus zuerst streichen, nicht den Kernbenchmark.