Verstehen
Textbausteine, Kontext, Attention und Sampling selbst verändern.
WOCHE 03
KI & DATA SCIENCE · WOCHE 03
LLM und Prompting · Prof. Dr. Mathias Engel
Zeitfenster: 0–5 Minuten seit Beginn · Einstieg
Begrüßen Sie mit dem konkreten Ziel: Heute entsteht ein benutzbares lokales Produkt. Keine Agentenarchitektur vorweg erklären. Fragen Sie, wer schon eine von KI erzeugte Datei tatsächlich außerhalb des Chats verwendet hat.
WOCHE 03
BUILD & CHECK
Ein einfacher Prompt, zwei Zielgruppen
Begriffe gruppieren lassen.
Die Erklärung für zwei Zielgruppen vergleichen.
Gegenprobe: Keine gemessenen Vektordistanzen erfinden.
Zeitfenster: 5–20 Minuten seit Beginn · Textbausteine / Bedeutungsraum
Starten Sie den kurzen Promptauftrag. Es geht nicht um ein neues HTML-Projekt, sondern um die unterschiedliche Verwendung derselben Begriffe. Lassen Sie vor dem Lesen eine erwartete Gruppierung nennen.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Welche Nähe ist plausibel — welche fragwürdig?
Nennt eine sinnvolle Gruppierung und einen Gegenfall.
Wortlabels und 3D-Koordinaten helfen beim Anschauen. Sie ersetzen weder echte Tokenisierung noch eine gemessene hochdimensionale Einbettung.Zielerkenntnis aufklappen
Zeitfenster: 5–20 Minuten seit Beginn · Textbausteine / Bedeutungsraum
Wählen Sie eine Gruppe und einen mehrdeutigen Begriff. Ziel ist die Grenze der Metapher. Erst nach den studentischen Beispielen die Erkenntnis aufklappen.
WOCHE 03
BUILD & CHECK
Was weiß das Modell noch nicht?
Vagen Eventauftrag ausprobieren.
Danach Termin, Budget und Teilnehmer nennen.
Gegenprobe: Welche Annahme kam von Euch — welche von der KI?
Zeitfenster: 20–35 Minuten seit Beginn · Kontext / Attention
Zwei getrennte Unterhaltungen machen den Kontextunterschied deutlicher. Die tatsächliche Antwort kann variieren. Studierende sollen gegebene Information von Ergänzungen unterscheiden, nicht einen vorhergesagten Text reproduzieren.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Welche Angabe hat die Antwort verändert?
Nennt eine Information, eine Berechnung und eine offene Frage.
Gute Steuerung liefert die benötigten Informationen und benennt Unbekanntes. Ein sprachlich sicherer Entwurf beweist nicht, dass die KI die fehlenden Fakten kennt.Zielerkenntnis aufklappen
Zeitfenster: 20–35 Minuten seit Beginn · Kontext / Attention
Lassen Sie zuerst einen konkreten Befund berichten. Fragen Sie nach der Herkunft der Angaben. Im Zielbefund sind 30 Personen, 600 EUR und der Termin gegeben; Raum/Catering werden gerechnet, weitere Anforderungen bleiben offen.
WOCHE 03
BUILD & CHECK
Vorhersagen, verändern, 50-mal ziehen
Im Folienlabor jeweils nur einen Parameter ändern.
Beobachtete Häufigkeiten mit den Balken vergleichen.
Gegenprobe: Ist weniger Vielfalt automatisch besser?
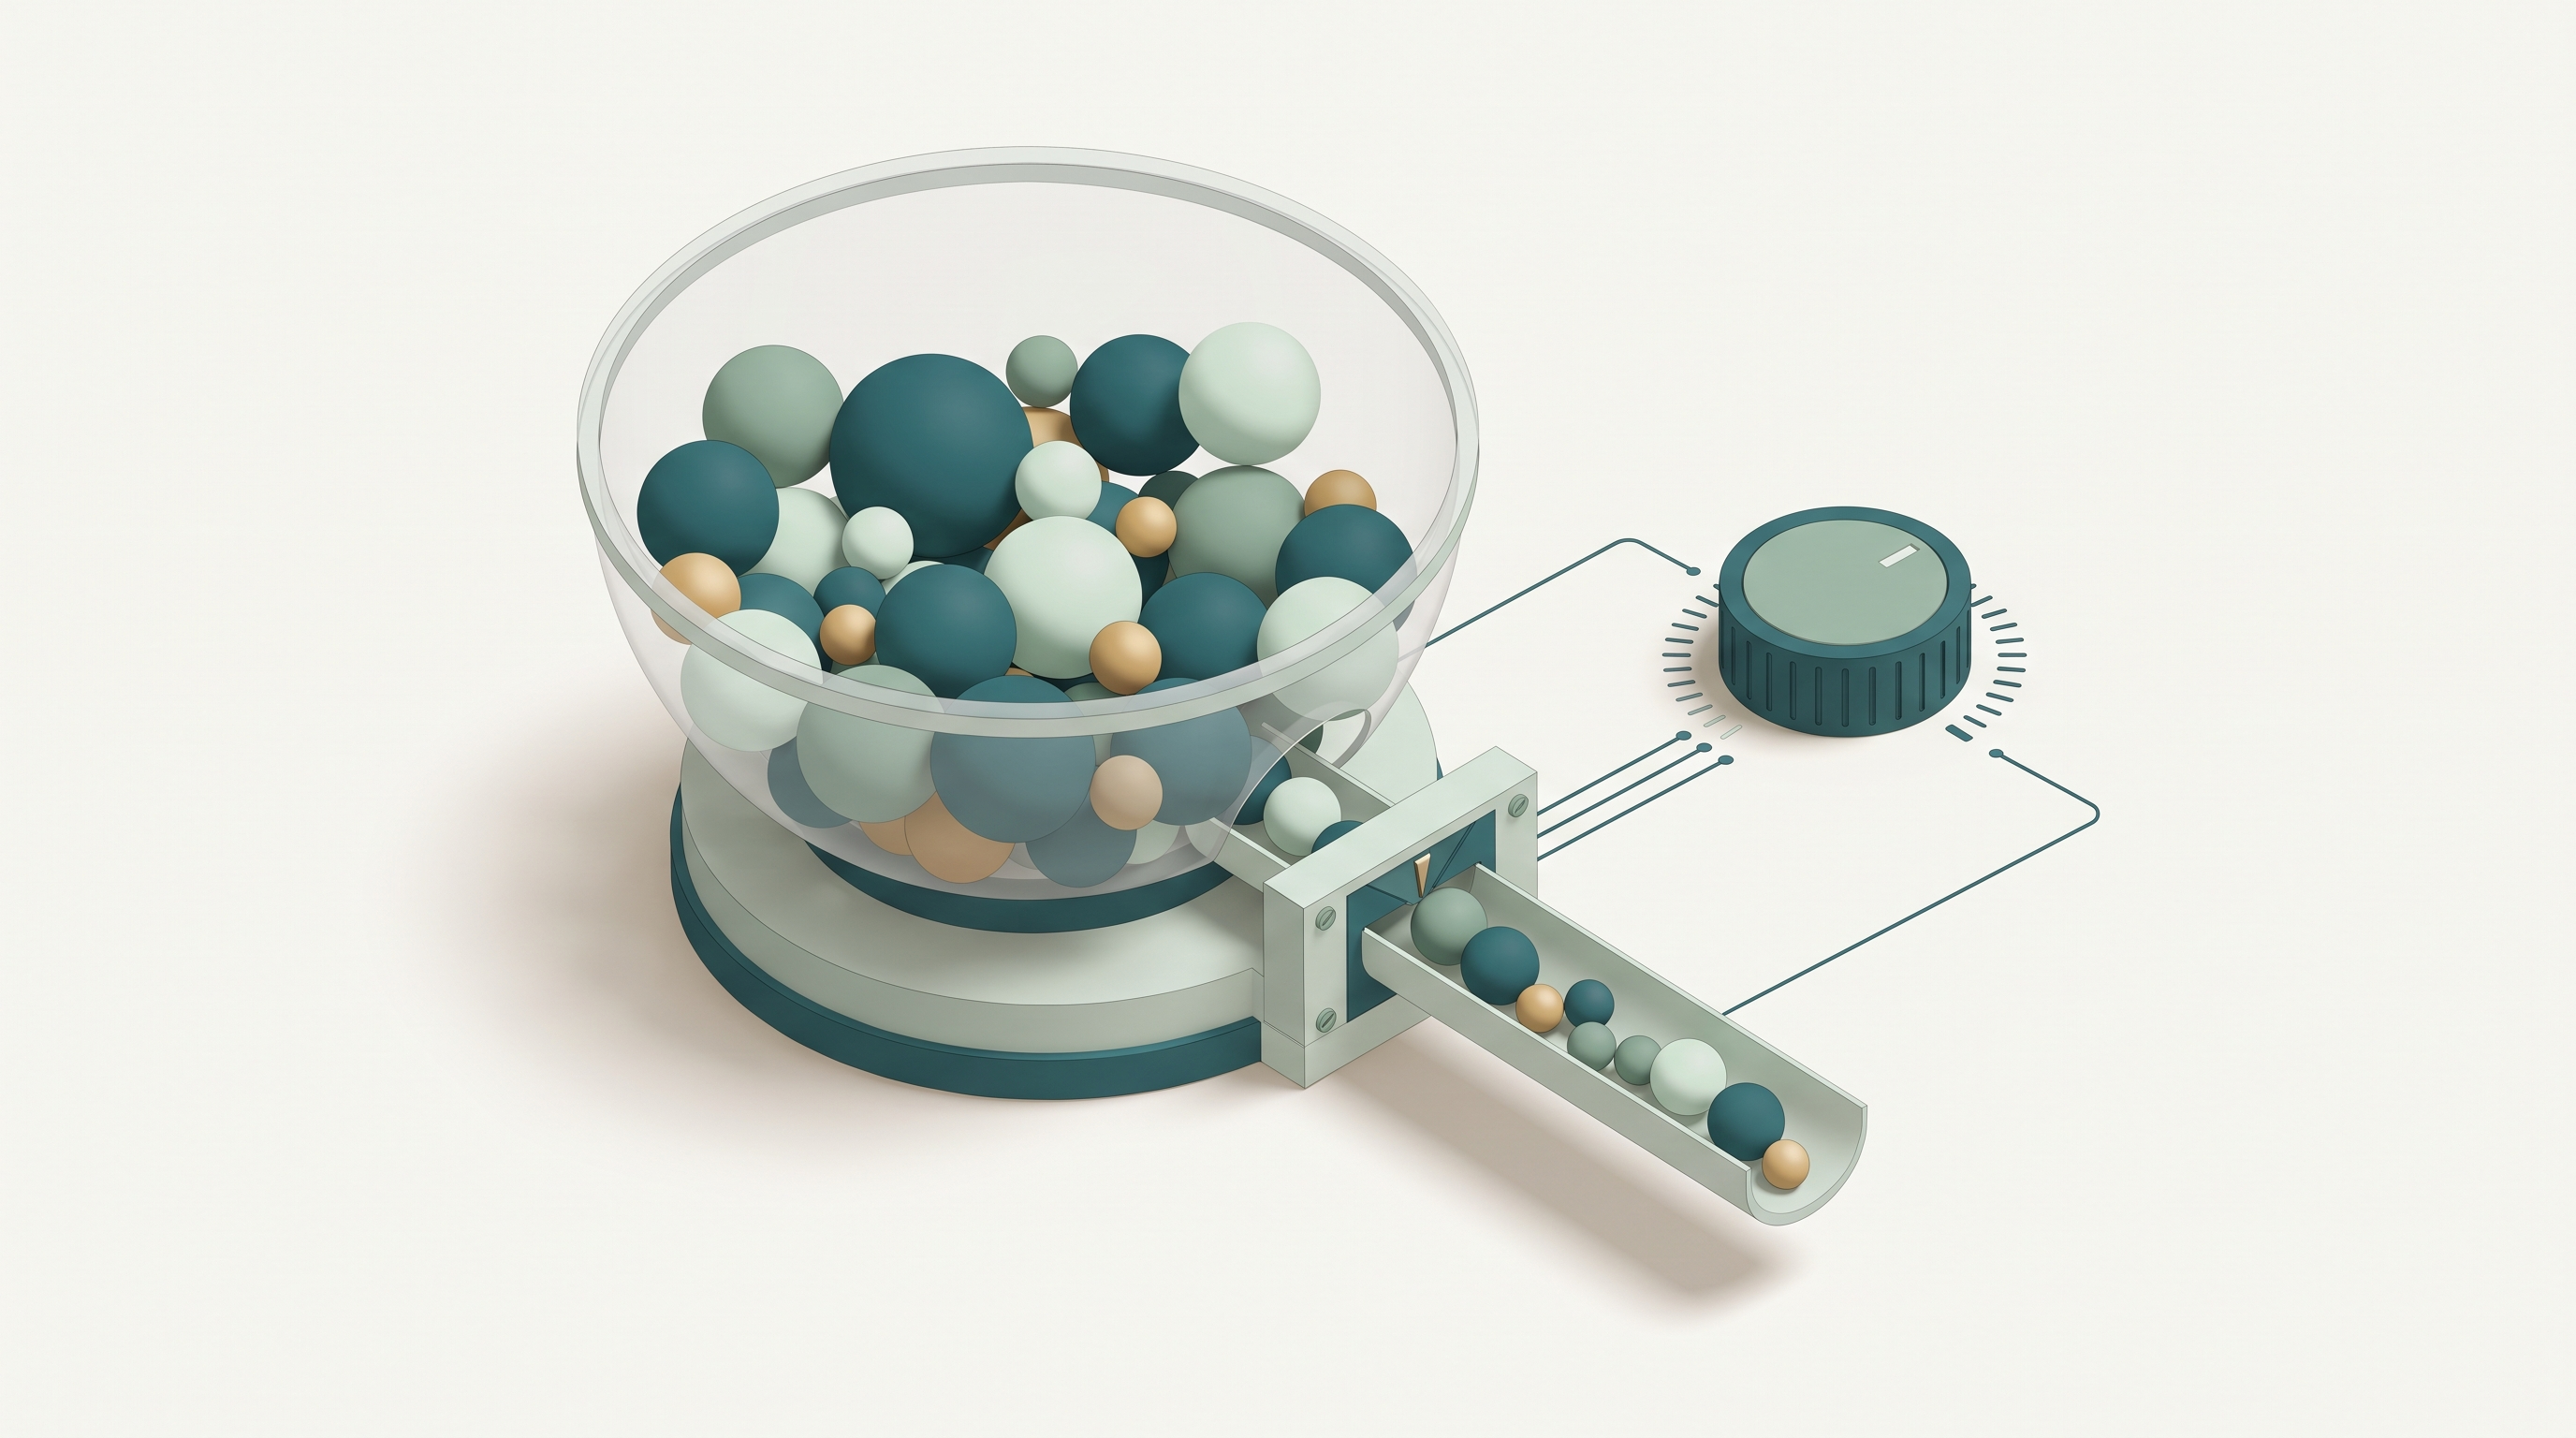
Zeitfenster: 35–50 Minuten seit Beginn · Sampling
Nutzen Sie das Parameterlabor auf der vorherigen Folie oder eine zweite Ansicht der Präsentation. Diese Übung benötigt keinen ChatGPT-Prompt zum angeblichen Verändern von API-Parametern. Auftragsvolltext enthält die fünf Schritte.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Was verändert Vielfalt — und was prüft Qualität?
Erklärt einen Parameter in einem Satz und nennt seine Grenze.
Temperature formt die Verteilung. Top-k/Top-p begrenzen Kandidaten. Fachliche Korrektheit muss separat geprüft werden; einzelne Zufallsziehungen sind noch kein stabiler Befund.Zielerkenntnis aufklappen
Zeitfenster: 35–50 Minuten seit Beginn · Sampling
Unterscheiden Sie erwartete Wahrscheinlichkeit und beobachtete Häufigkeit. Fünfzig Ziehungen können sichtbar streuen. Beim Wechsel setzt das Labor die Zähler zurück, damit alte und neue Bedingungen nicht vermischt werden.
WOCHE 03
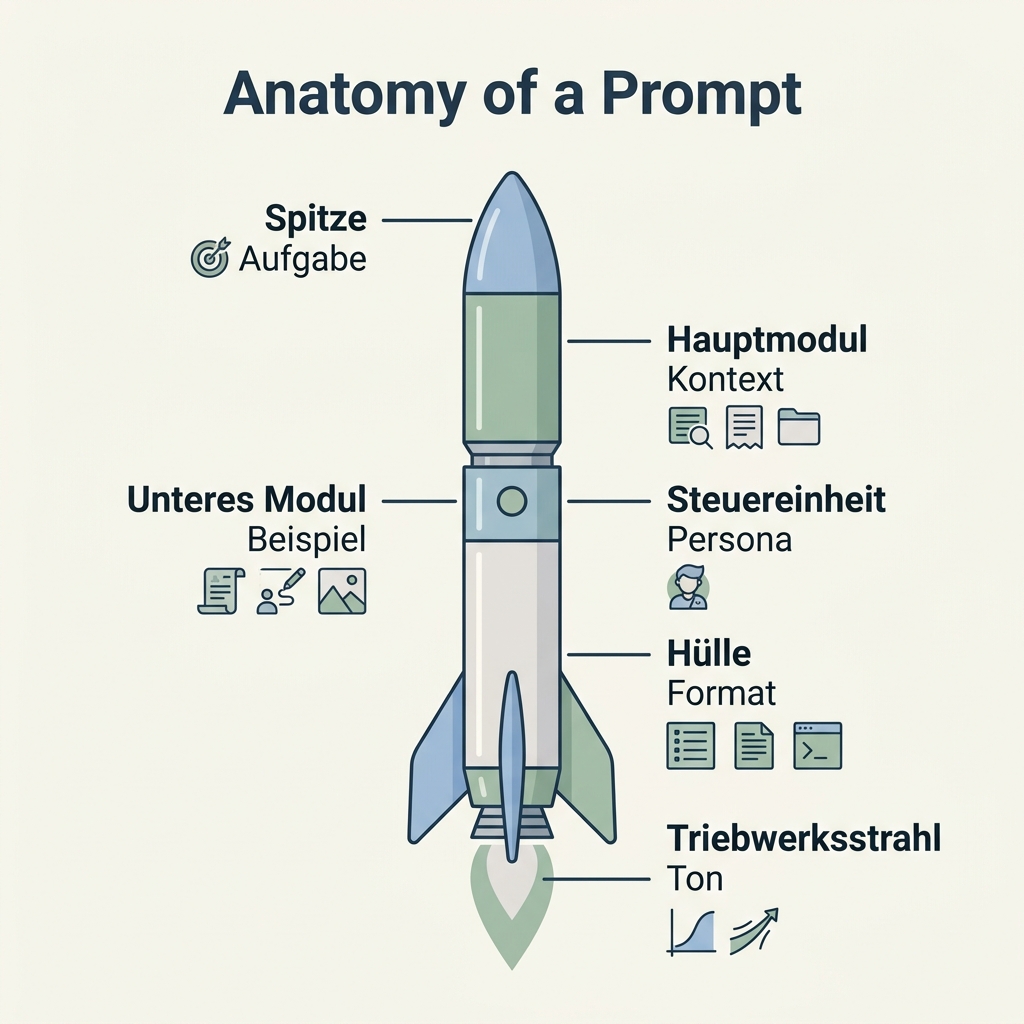
Ein Prompt ist ein kleiner Bauplan.
Aufgabe und Kontext geben Richtung und Material vor.
Zielgruppe, Ton und Format bestimmen die Form. Beispiele und Abnahmekriterien machen das Ergebnis überprüfbar.
Zeitfenster: 50–65 Minuten seit Beginn · Prompting
Erklären Sie am Budgetrechner: Eine schöne Antwort ohne prüfbare Formel ist nicht genug. Rolle und Ton können helfen; sie ersetzen keine Daten und Kriterien. Der Bauplan ist ein Arbeitsmodell, kein universelles magisches Promptrezept.
WOCHE 03
BUILD & CHECK
Baue einen kleinen Budgetrechner
Prompt in ChatGPT nutzen und Datei erzeugen lassen.
Die HTML-Datei außerhalb des Chats öffnen.
Gegenprobe: 30×12+160=520; Rest 80. Was passiert bei 0 Personen?
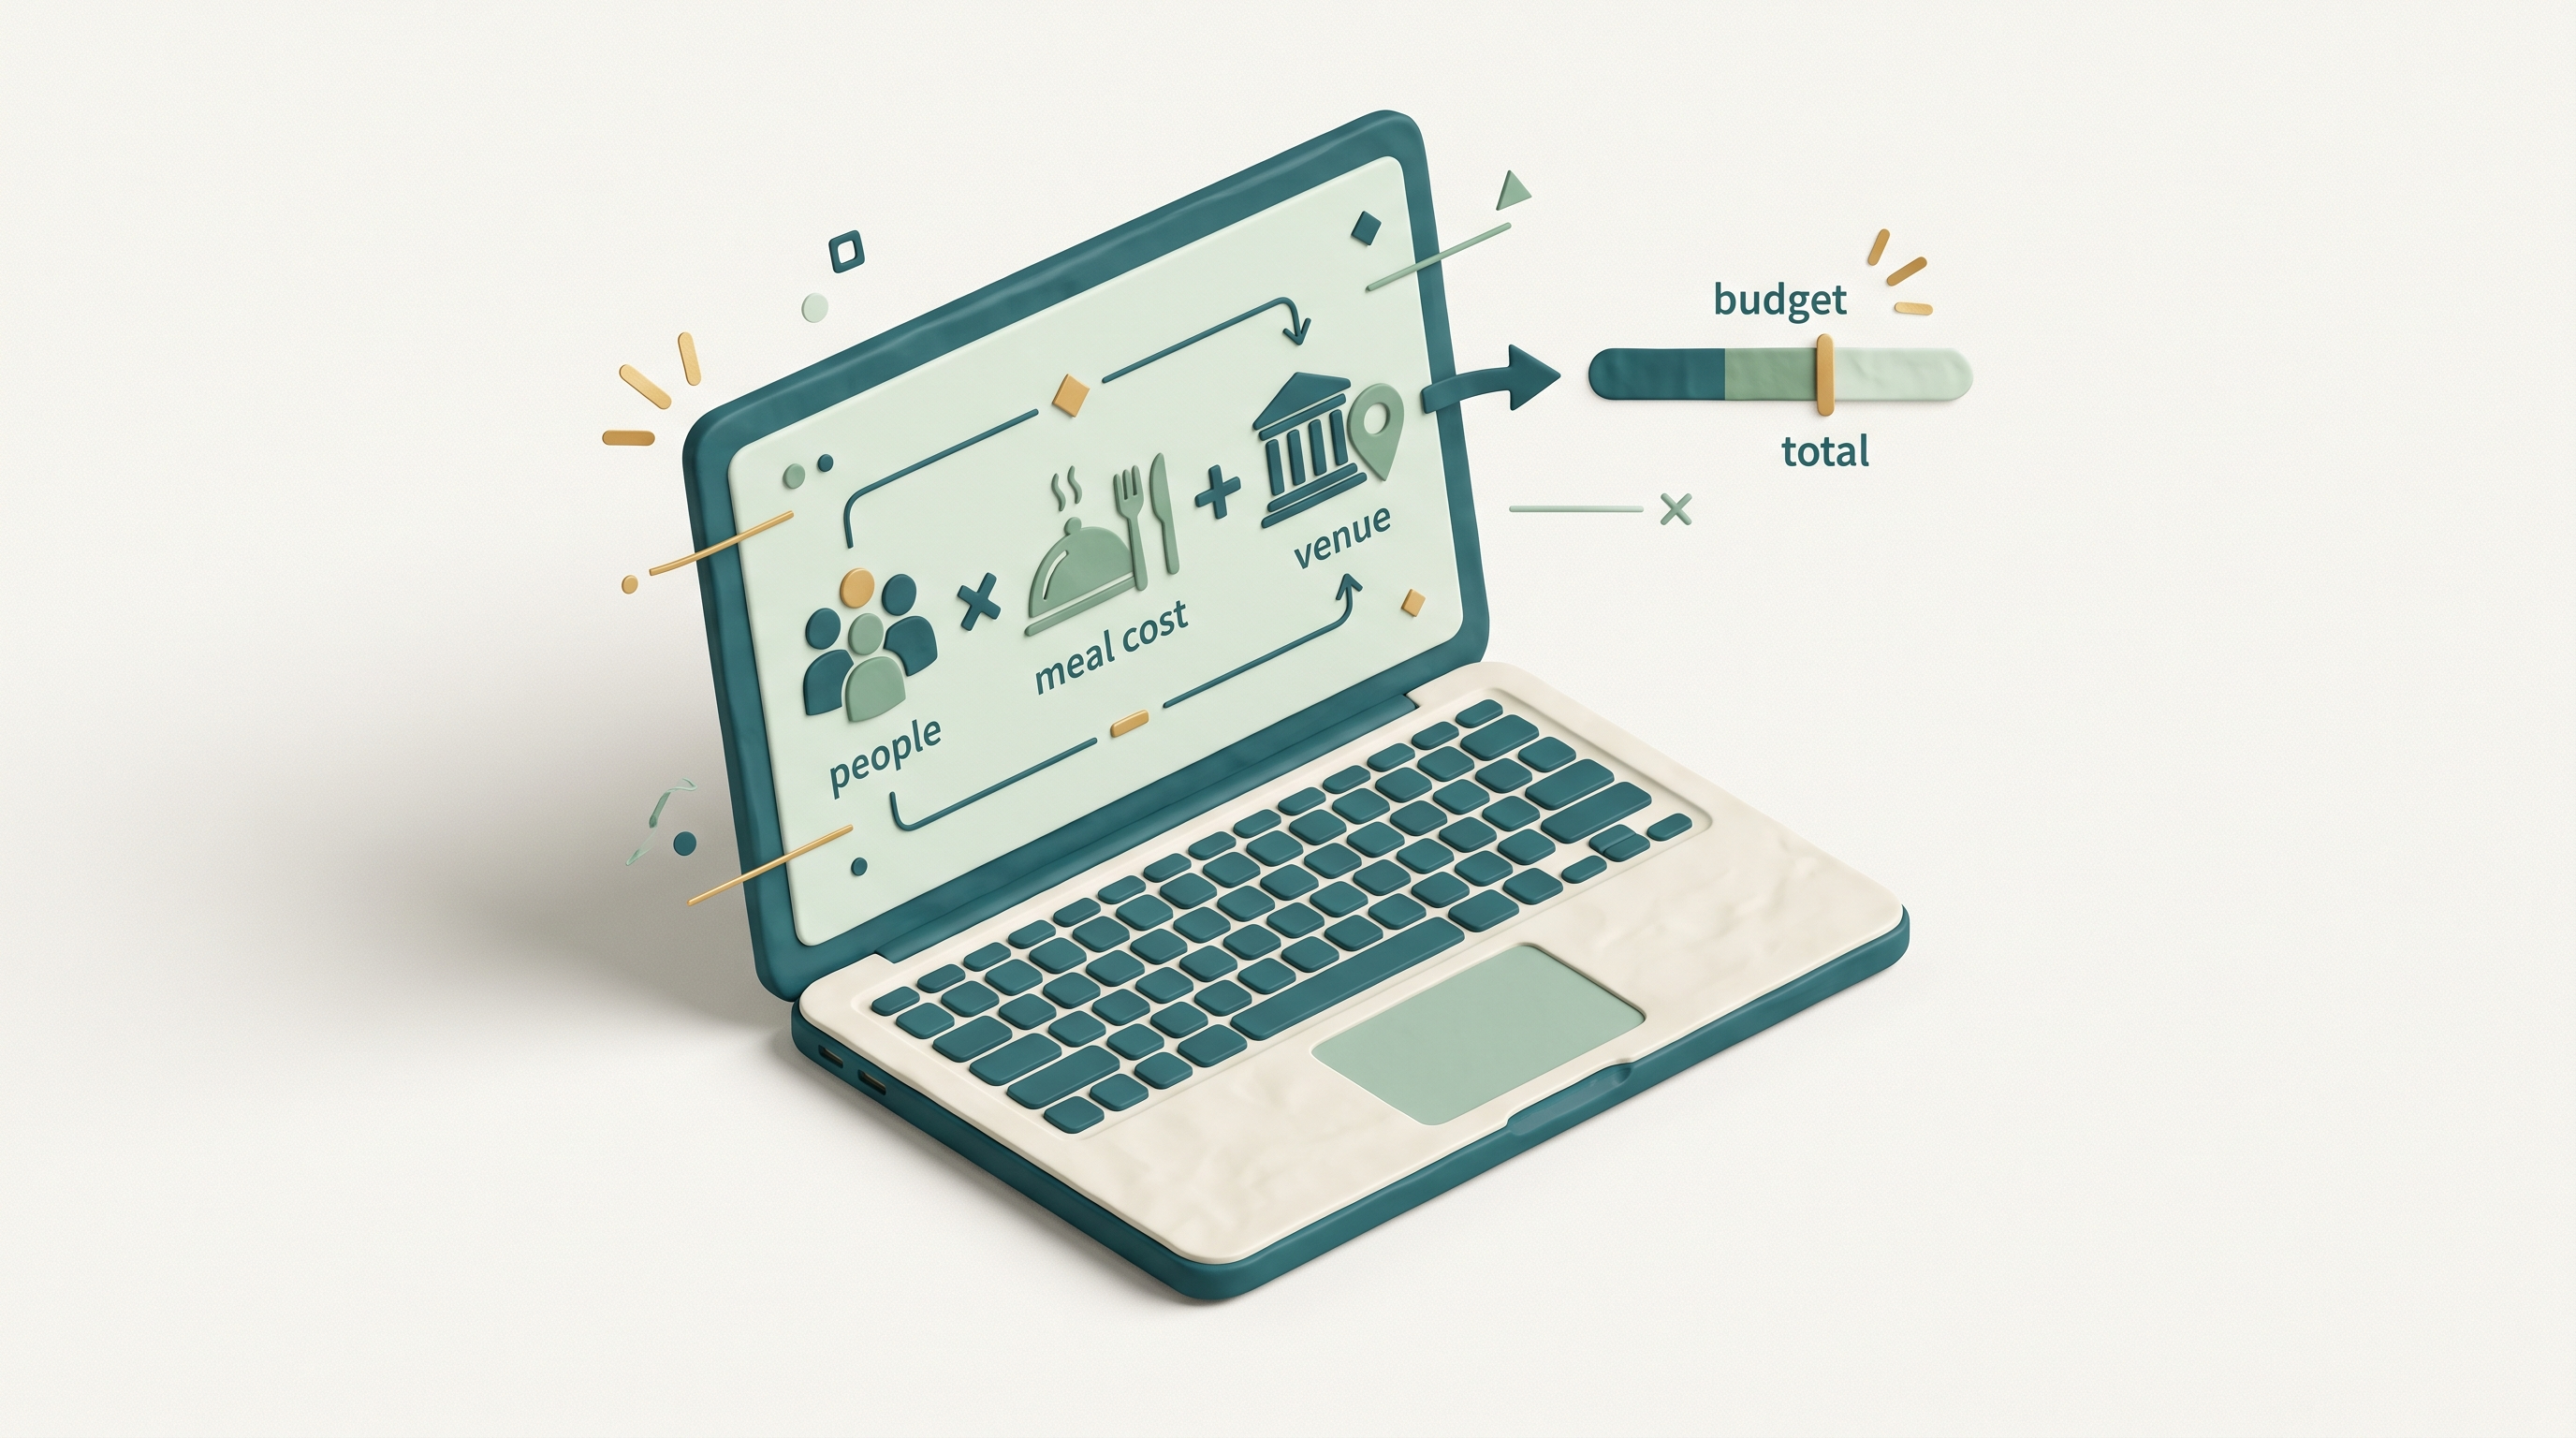
Zeitfenster: 50–65 Minuten seit Beginn · Prompting
Kurzer erster Dateibau. Verfügbarkeit der Dateiausgabe kann je Client variieren; Code speichern ist der Rückfallweg. Die spätere große Aufgabe baut auf diesen Eingaben auf. Timer nicht während einer ungeklärten Installation starten.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Ist die Rechnung richtig und die Bedienung verständlich?
Zeigt den Basisfall und genau einen ungültigen Eingabefall.
Ein gutes Ergebnis erfüllt Auftrag und Gegenprobe. KI erzeugter Code ist ein prüfpflichtiger Entwurf, kein fertiger Qualitätsnachweis.Zielerkenntnis aufklappen
Zeitfenster: 50–65 Minuten seit Beginn · Prompting
Rechnen Sie den Basiswert sichtbar nach. Ein Rechner, der NaN oder eine leere Erfolgsmeldung zeigt, benötigt Verbesserung. Unterschiede zwischen optischer Qualität und Funktionsqualität ansprechen.
WOCHE 03
Fünf konkrete Fähigkeiten:
1 Rechnen: Gesamtkosten und Restbudget.
2 Regeln: Kapazität, Mindestmenge, Zugänglichkeit.
3 Termine: Öffnungszeiten und Kollisionen.
4 Vergleichen: Varianten A/B.
5 Mitnehmen: JSON speichern/laden; offline weiterarbeiten.
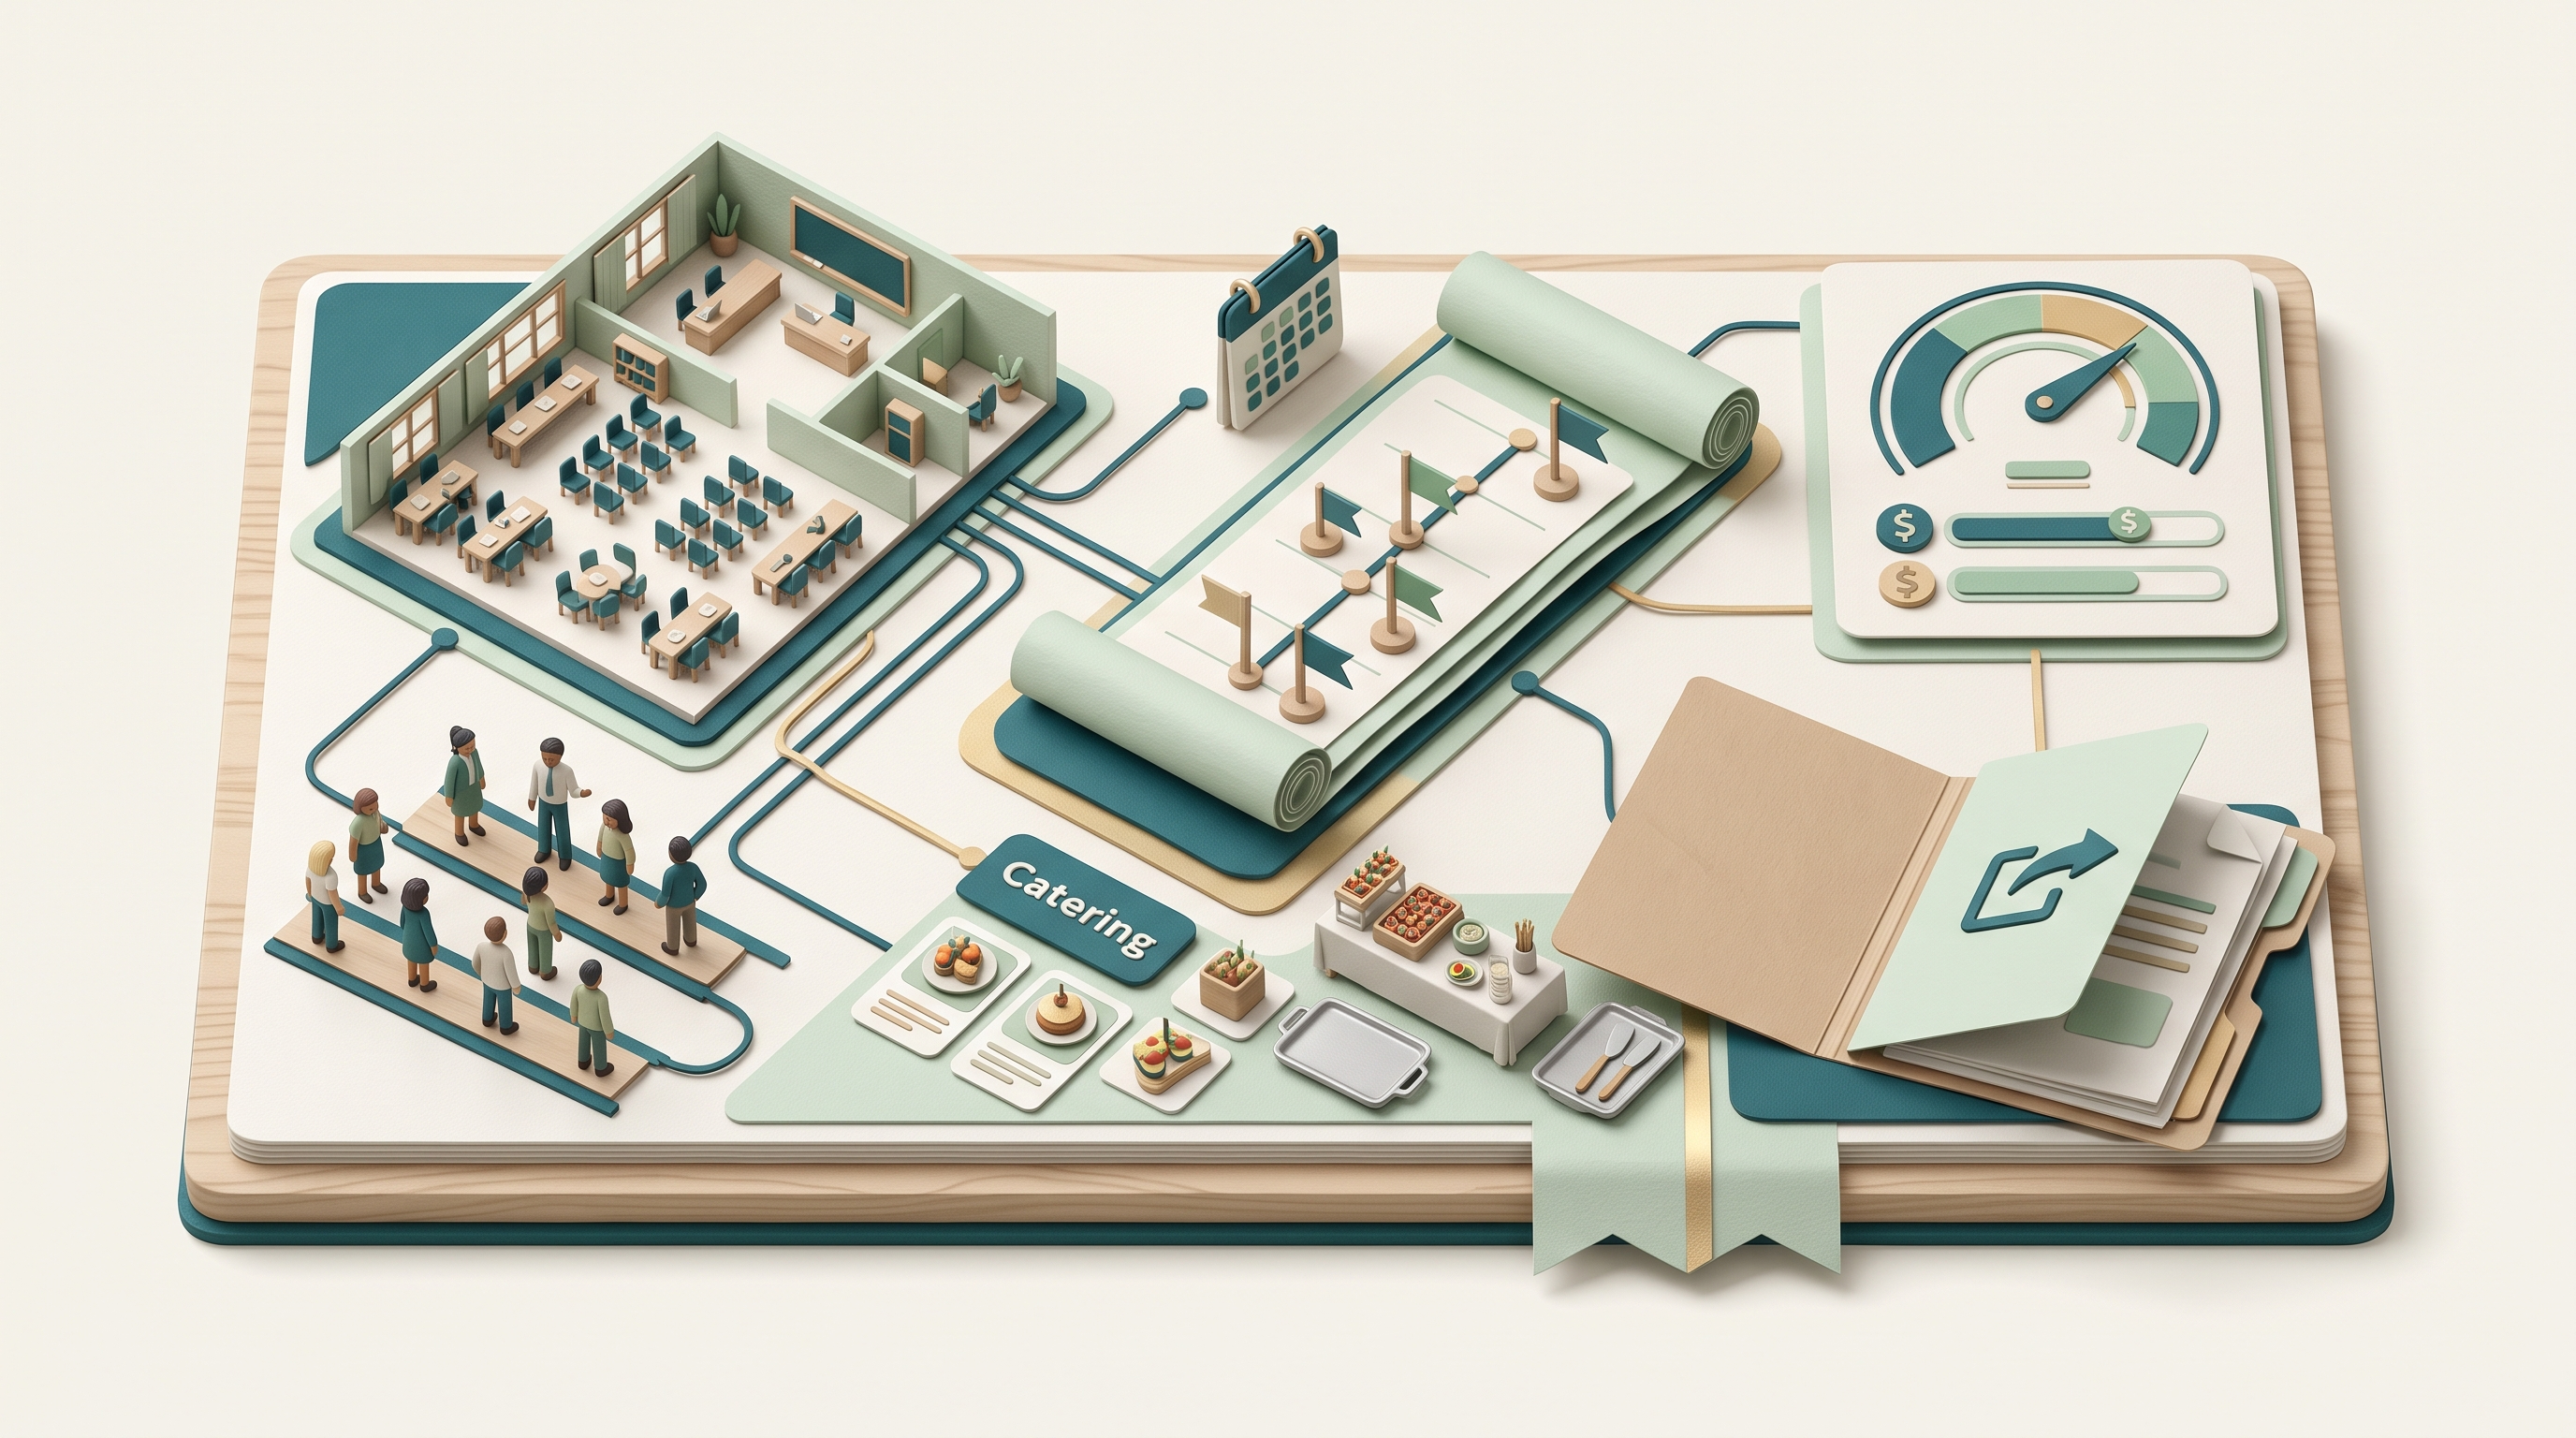
Zeitfenster: 80–85 Minuten seit Beginn · Fünf Fähigkeiten
Zeigen Sie nur das Zielbild und die Abnahmekriterien. Lernwerkstatt und Fußballtafel jetzt noch nicht öffnen: Diese Beispiele kommen während der laufenden Generierung. Mindestversion klein halten; Erweiterungen erst nach funktionierendem Kern.
WOCHE 03
BUILD & CHECK
Jetzt bauen — danach gemeinsam prüfen
Vollständigen Auftrag starten; Eingabedaten sind enthalten.
Während die KI arbeitet: Newsflash und zwei Beispieldemos.
Gegenprobe: Mindestversion vor Extras: rechnen, Grenzen, Konflikte, Varianten, Export.
Zeitfenster: 85–110 Minuten seit Beginn · Bau mit Newsflash und Demos
85–88 Bau starten und Setup prüfen. 88–94 kurzer Newsflash. 94–102 Lernwerkstatt/Fußballtafel, je vier Minuten, erst während des Baus. 102–110 eigene Mindestversion öffnen. Noch kein blindes Publishing; eigener Repo-/Pages-Schritt folgt mit separater Freigabe. Bei technischen Problemen News kürzen.
WOCHE 03
BUILD & CHECK
Vom Projektordner zur Offline-App
Eigenen GitHub-Zugang prüfen; Anmeldung und MFA selbst erledigen.
Codex veröffentlicht erst nach Deiner Repo-/Sichtbarkeitsfreigabe.
Pages öffnen, installieren, Netzwerk aus und neu starten.
Gegenprobe: Funktioniert die App nach dem ersten Laden auch ohne Netz?
Zeitfenster: 110–120 Minuten seit Beginn · GitHub / Pages / Offline-PWA
110–120: Zeigen Sie den sicheren Ablauf Account → Login → Repo-/Dateiprüfung → explizite Veröffentlichungsfreigabe → Pages → Installation → Offline-Neustart. Keine Passwörter/Tokens an KI geben. Ohne Zugang die vorbereitete PWA prüfen; Konto ggf. anschließend selbst anlegen. Ein statisches Pages-Repo führt keinen Python-Agentenserver aus.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Kann jemand die Mindestversion schon bedienen?
Zeigt Eingabe → Berechnung → Rückmeldung, nicht den gesamten Code.
Ein lauffähiger Kern ist wertvoller als viele ungetestete Extras. Generierungsdauer und Ergebnisqualität sind getrennte Beobachtungen.Zielerkenntnis aufklappen
Zeitfenster: 120–125 Minuten seit Beginn · Bau-Wrap-up
Lassen Sie ein Ergebnis kurz zeigen. Bei langsamen oder defekten Generationen die lokale Muster-App verwenden, damit die Testphase für alle möglich bleibt. Fünf Minuten, keine neue Funktionswunschliste.
WOCHE 03
BUILD & CHECK
Bringe die Anwendung an ihre Grenzen
Sechs bekannte Fälle tatsächlich eingeben.
Soll und Ist mit einem konkreten Befund notieren.
Gegenprobe: Kapazität, Budget, Kollision und angrenzender Termin.
Zeitfenster: 125–133 Minuten seit Beginn · Anwendung testen
Acht Minuten reichen für eine verteilte Testmenge. Geben Sie jedem Person zwei Fälle, sammeln Sie danach. Die Kernwerte sind im Auftragsvolltext. Keine nicht ausgeführten Tests als bestanden markieren.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Welcher Fehler lässt sich reproduzieren?
Formuliert einen Fehler so, dass ein anderes Person ihn nachstellen kann.
Ein brauchbarer Fehlerbericht nennt Eingaben, Erwartung und tatsächliches Ergebnis. „Funktioniert nicht“ ist noch kein präziser Verbesserungsauftrag.Zielerkenntnis aufklappen
Zeitfenster: 133–136 Minuten seit Beginn · Test-Wrap-up
Unterscheiden Sie Anwendungsfehler und falsche Testannahme. Direkt angrenzende Termine sind im Lehrfall erlaubt. Aus einer beobachteten Störung nicht sofort eine allgemeine Modellschwäche ableiten.
WOCHE 03
BUILD & CHECK
Verbessere v0 gezielt zu v1
Datei und Fehlerbericht gemeinsam an die KI geben.
Neue Version getrennt sichern und alte Tests wiederholen.
Gegenprobe: Ist der Fehler behoben, ohne einen anderen einzubauen?
Zeitfenster: 136–144 Minuten seit Beginn · Gezielte Verbesserung
Zehn Minuten Reparatur. Keine vollständige Neugestaltung auf Verdacht. Wenn der Build länger dauert, können Sie einen kurzen bekannten Fehlerbefund vorführen; die Rückfall-App bleibt verfügbar.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Was wurde nachweislich besser?
Zeigt denselben Fall vor und nach der Änderung.
Gezielte Änderung plus Regressionstest ist eine belastbarere Verbesserung als ein neuer hübscher Gesamtwurf. Die alte Version bleibt als Vergleich erhalten.Zielerkenntnis aufklappen
Zeitfenster: 144–147 Minuten seit Beginn · Verbesserungs-Wrap-up
Erst tatsächliche Wirkung erfragen, dann Zielerkenntnis aufklappen. Falls nichts besser wurde: Auch ein sauber belegter negativer Befund ist wertvoll. Keine Verbesserung erfinden.
WOCHE 03
BUILD & CHECK
Eine andere Person testet Deine App
Ohne Bedienhilfe: Basisfall, Kapazitätsfehler und Export.
Rückmeldungen mit kurzem Fragebogen sammeln.
Gegenprobe: Beobachtung, Bewertung und Verbesserung trennen.
Zeitfenster: 147–152 Minuten seit Beginn · Test durch andere Person
147–152: Jede Person holt Rückmeldung einer anderen Person ein. Keine vorgeschriebene Zweiergruppe und kein gemeinsamer Entwicklungsauftrag. Erst beobachten, dann gezielt nachfragen. Keine Namen erfassen.
WOCHE 03
WRAP-UP · GEMEINSAM BEGRÜNDEN
Welche Rückmeldung half wirklich?
Nennt eine Verbesserung samt beobachtetem Anlass.
Nutzungsbeobachtung deckt Fehler auf, die beim Bauen unsichtbar bleiben. Benutzbar, korrekt und schön sind verwandte, aber unterschiedliche Kriterien.Zielerkenntnis aufklappen
Zeitfenster: 152–155 Minuten seit Beginn · Feedback-Wrap-up
152–155: Eine konkrete Beobachtung aus dem Fragebogen berichten lassen und erst dann die Erkenntnis aufklappen.
WOCHE 03
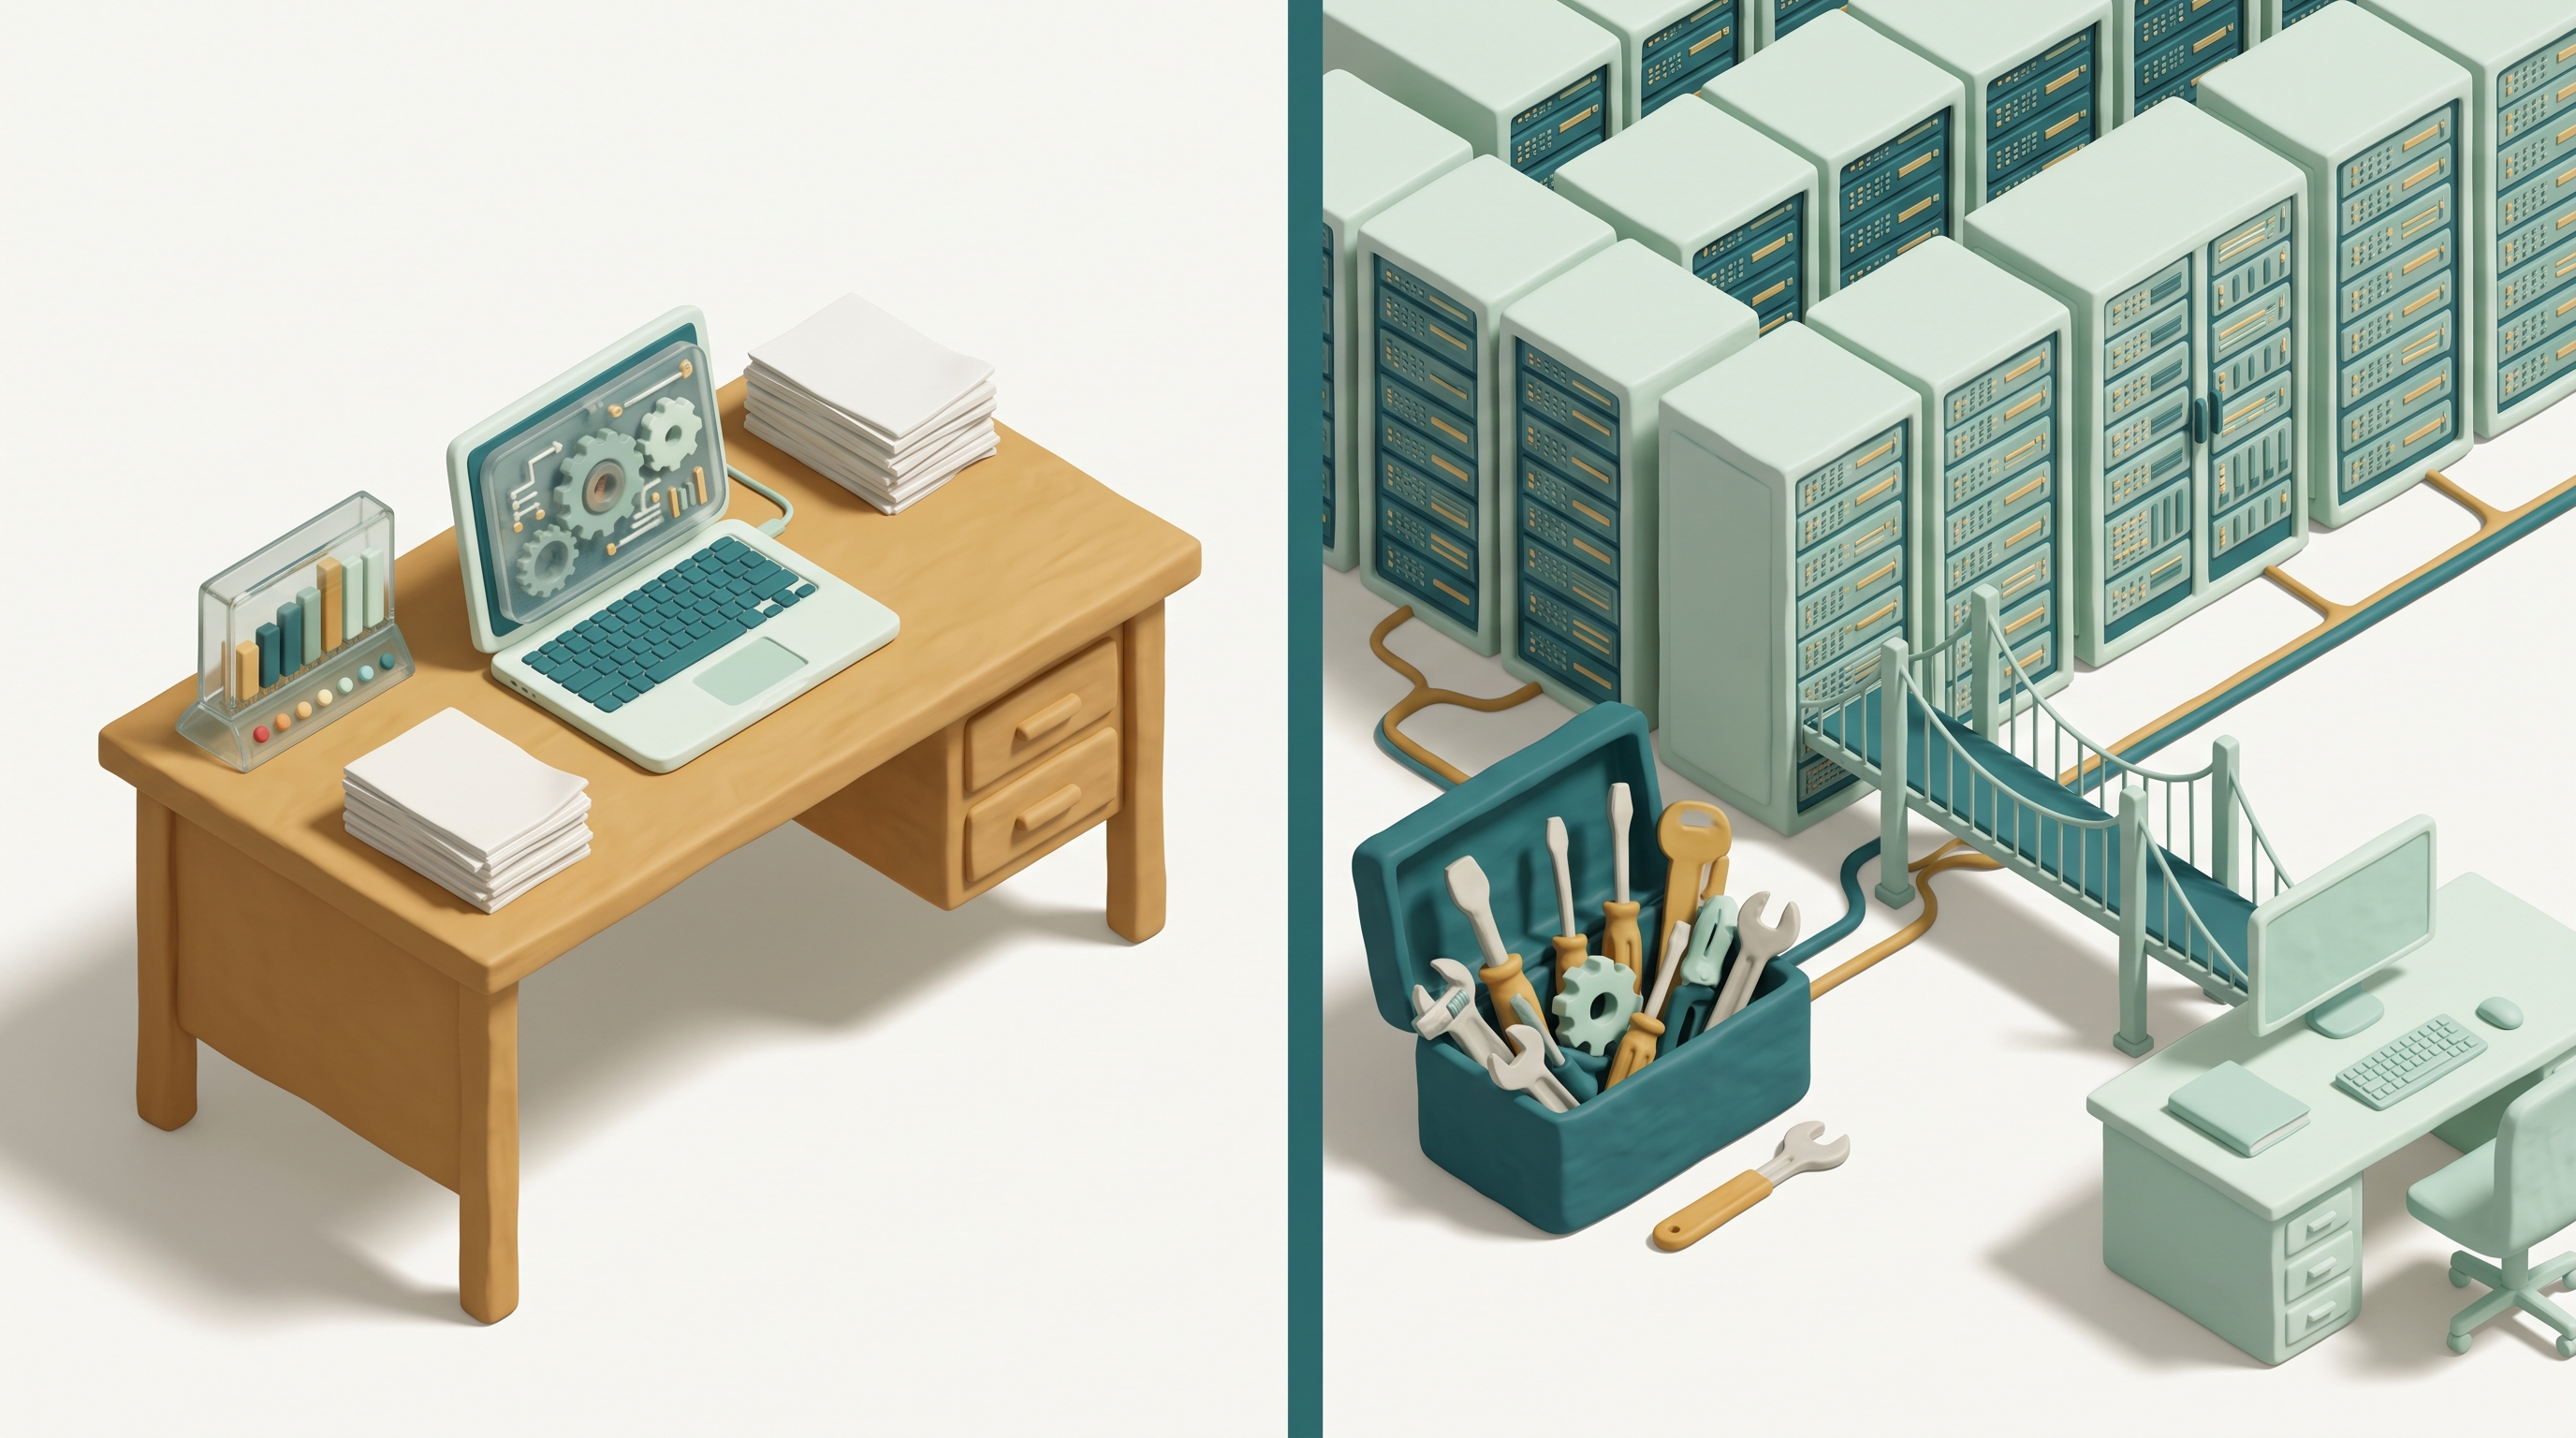
Offene Gewichte: das Modell selbst betreiben.
Gewichte sind herunterladbar. Lokaler Betrieb, Spezialisierung und eigene Infrastruktur werden möglich – je nach Lizenz.
Stärken: Kontrolle und begrenzte Offline-Aufträge. Grenzen: RAM/VRAM, Kontext, Tempo, Einrichtung und eigene Qualitätsprüfung.
Zeitfenster: 155–175 Minuten seit Beginn · Open Weights / Cloud / lokal
155–165: Warum Anbieter Gewichte freigeben: Verbreitung, Forschung, Anpassung und Ökosystem; Motive unterscheiden sich. Open Weight ist nicht automatisch Open Source oder kostenloser Betrieb. Kandidat in AA wählen, Hardware/Quantisierung/Kontext prüfen, dann bekannten Test in Ollama ausführen. Nicht pauschal kleinere Modelle als schlechter oder besser bezeichnen.
WOCHE 03
Cloud: verwaltete Rechenleistung und oft starke Werkzeuge.
Große Modelle, Updates und multimodale Dienste ohne lokalen Modelldownload. Keine pauschale Überlegenheit in jeder Aufgabe.
Grenzen: Netz/Konto, laufende Limits/Kosten, Datenfluss und Abhängigkeit vom Anbieter. Open-Weight-Modelle können ebenfalls in der Cloud laufen.
Zeitfenster: 155–175 Minuten seit Beginn · Open Weights / Cloud / lokal
165–175: Dieselbe Aufgabe in Cloud und vorbereitetem lokalem Modell vergleichen. Kontext und Temperature in Ollama zeigen; Cloud-/Websuche als externe Verarbeitung benennen. LM Studio am Ende kurz als alternative lokale Oberfläche. Freiwilliger Heimtest, keine Kauf-/Installationspflicht.
WOCHE 03
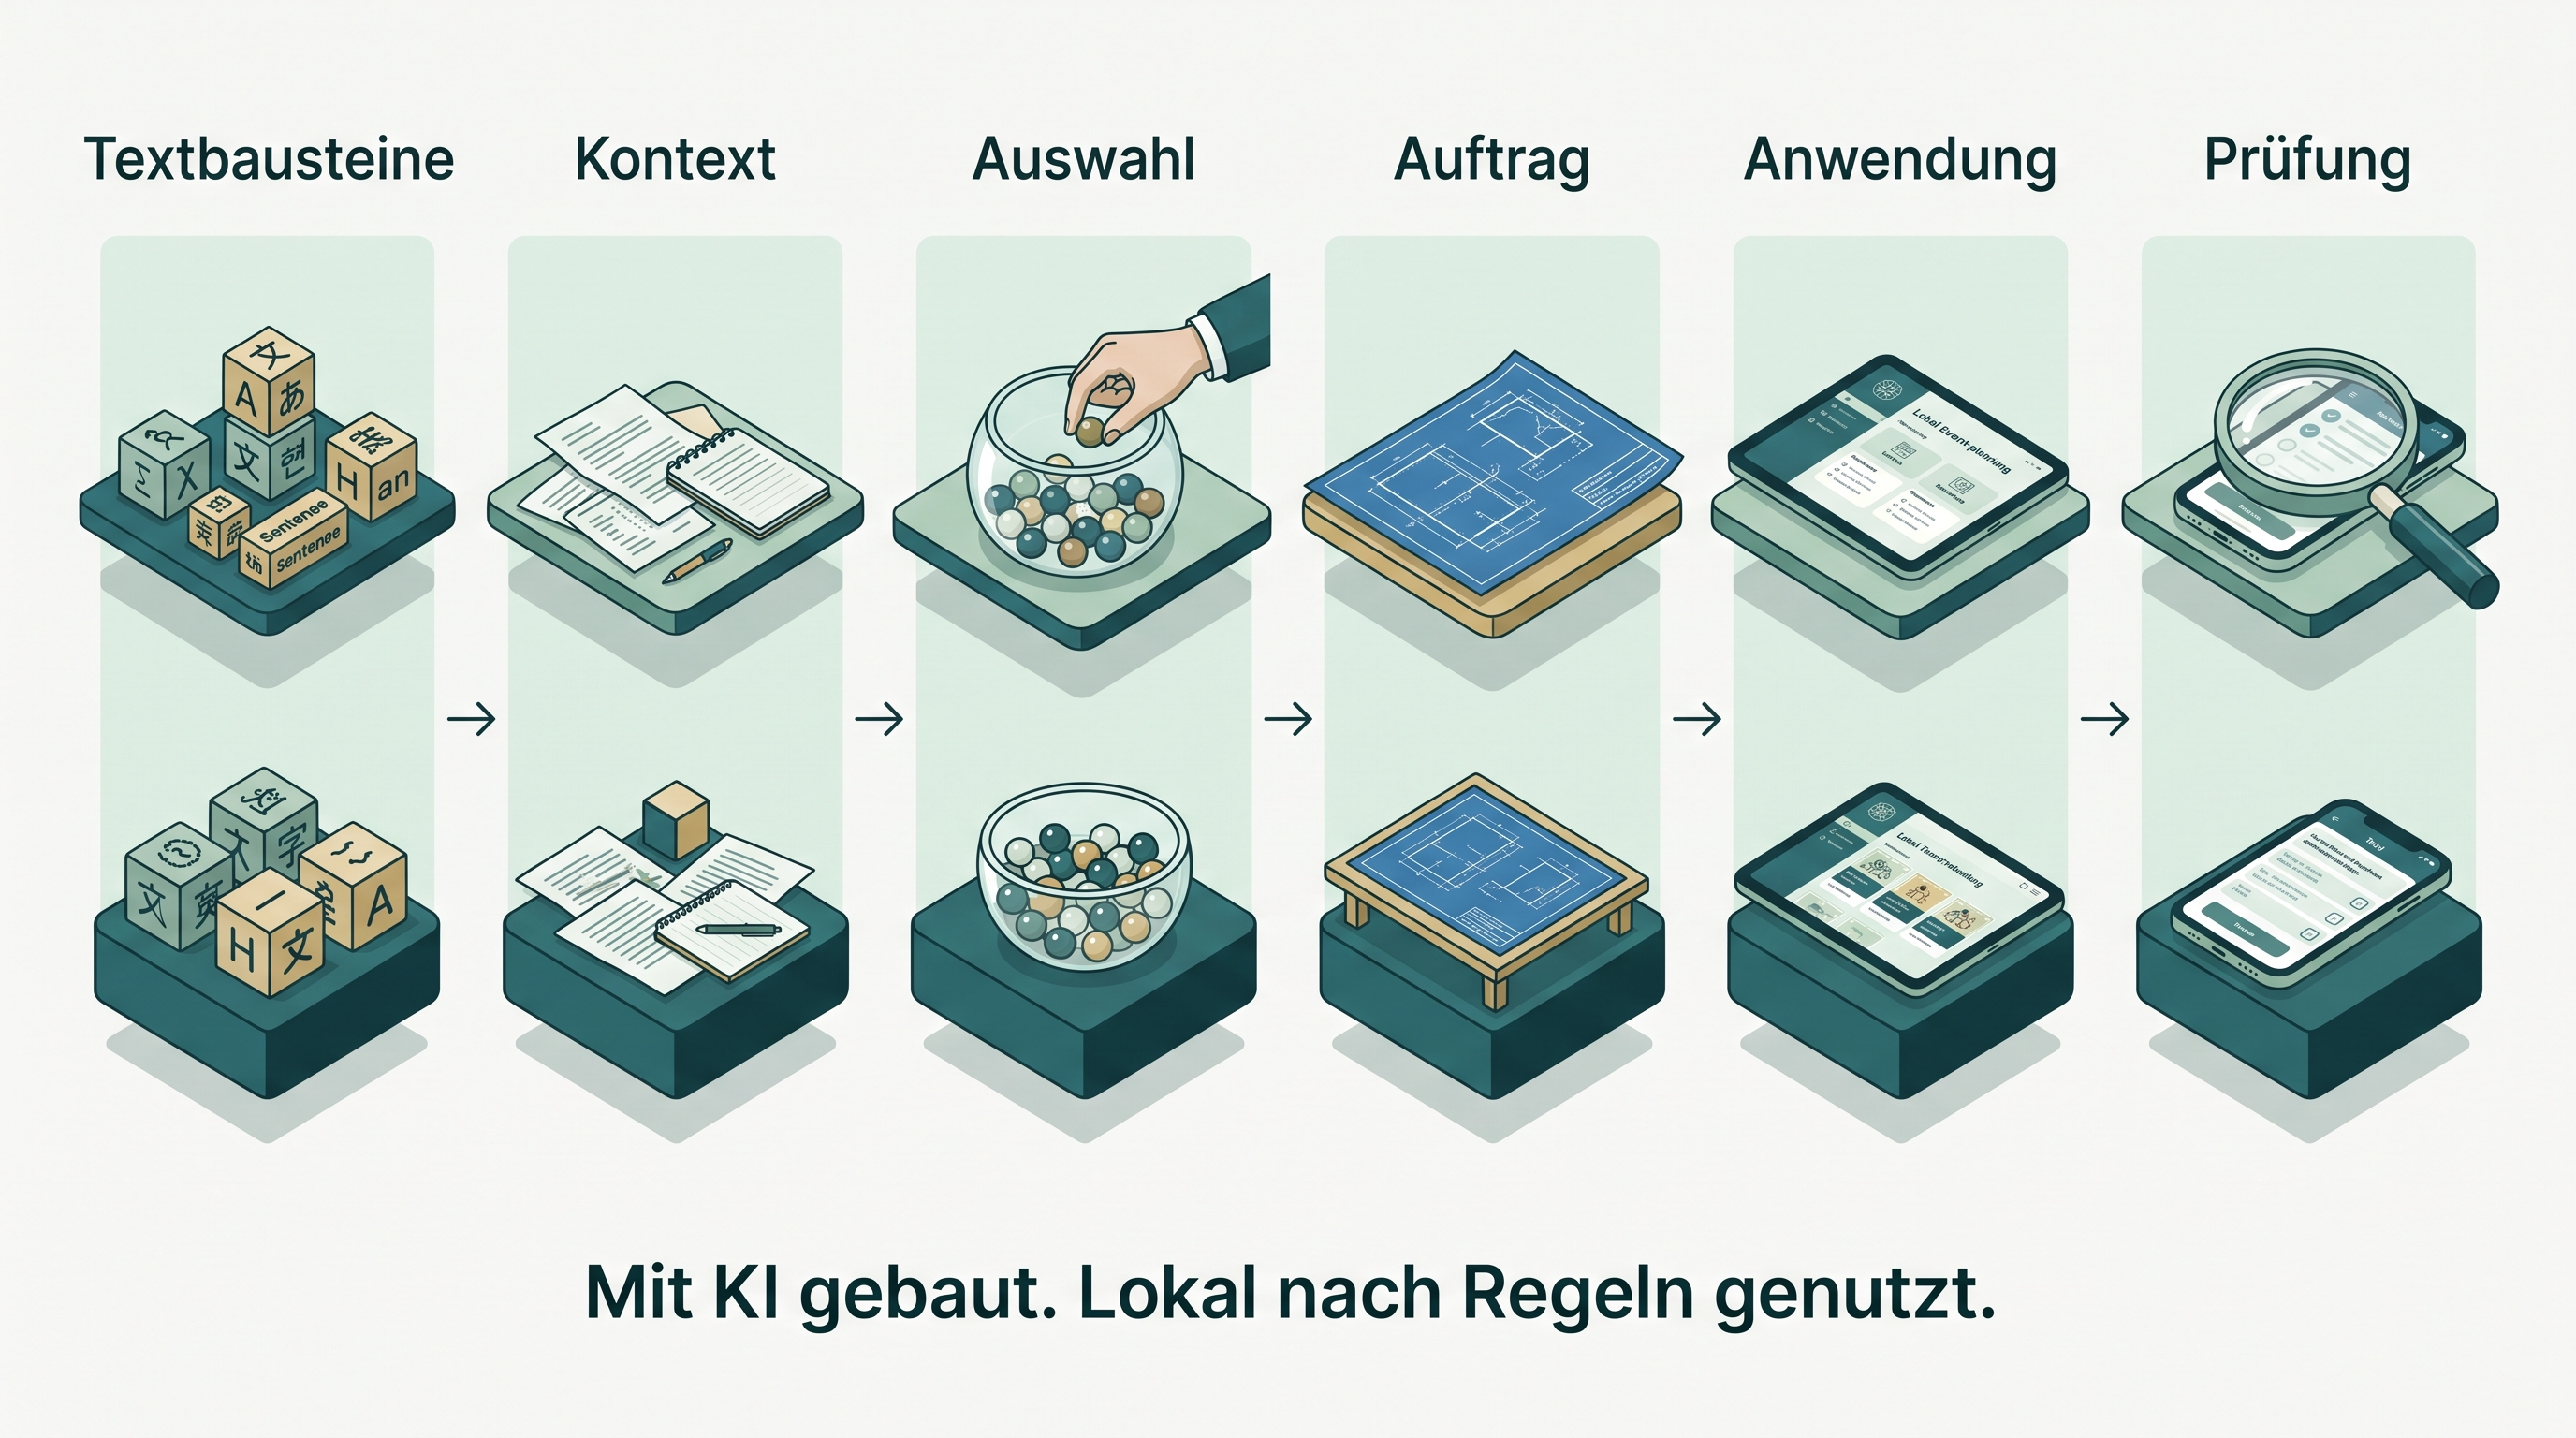
Zeitfenster: 175–180 Minuten seit Beginn · Transfer / Big Picture / Quellen
Initialfrage erneut beantworten. Keine neue Theorie. Folgen Sie kurz dem Weg von Sprache über Kontext und Auswahl bis zum prüfbaren Produkt. Die Infografik ist tatsächlich generiert; genaue Mechanismen wurden zuvor im HTML-Labor ausprobiert.
OpenAI · 2026 · Abruf 2026-10-19
Modellbezogene Ausgabedimensionen: text-embedding-3-small standardmäßig 1536, text-embedding-3-large 3072; keine allgemeine Dimensionszahl für alle Modelle.
official; Dimensionsabschnitt geöffnet/geprüft
https://developers.openai.com/api/docs/guides/embeddings
Qwen · 2025 · Abruf 2026-10-19
hidden_size 4096 als konkretes Beispiel interner Modellbreite; nicht mit ausgegebenen Text-Embeddings gleichsetzen.
primary model publisher; config geöffnet/geprüft
https://huggingface.co/Qwen/Qwen3-8B/blob/main/config.json
Polo Club of Data Science, Georgia Tech · 2024 · Abruf 2026-10-19
Visuelle Erklärung der Verarbeitung und Gewichtung im Transformer; lokale eigene Demo muss didaktische Vereinfachungen kennzeichnen.
primary educational visualization; geöffnet; kein vollständiger Funktionsaudit
https://poloclub.github.io/transformer-explainer/
Hugging Face · 2026 · Abruf 2026-10-19
Temperature verändert Verteilung; Top-k beschränkt Kandidatenzahl und Top-p kumulierte Wahrscheinlichkeit. Keine Wahrheitsgarantie oder universelle Client-Unterstützung.
official; GenerationConfig geöffnet/geprüft
https://huggingface.co/docs/transformers/v5.1.0/en/main_classes/text_generation
Nutzerbereitgestellte Referenz · 2026 · Abruf 2026-10-19
Didaktische Inspiration: durchgehender Fall, Experimente, Promptvergleich und Einrichtung/Ausführung/Prüfung.
contextual; vier Kapitel und verlinkte Übungseinstiege im Browser gelesen, nicht vollständig absolviert
https://praesentationshub.bjmxbxyqfs.chatgpt.site/#start
Prof. Dr. Mathias Engel · 2026 · Abruf 2026-10-19
Referenz für konkrete interaktive Lernanwendung; keine vollständige technische Funktionsbestätigung.
contextual; Startansicht textlich und visuell im Browser geprüft; kein Offlineaudit
https://profengel.github.io/lernwerkstaetten/
Prof. Dr. Mathias Engel · 2026 · Abruf 2026-10-19
Referenz für Taktikboard und anschauliche regelbasierte Interaktionen.
contextual; Startansicht textlich und visuell im Browser geprüft; kein vollständiger Offline-/Simulationsaudit
https://profengel.github.io/fussball-taktik/
Kursplanung nach Nutzerauftrag · 2026 · Abruf 2026-10-19
Fiktiver Lehrfall, Wortlandschaft, Attention-Schema und Sampling-Demo; keine echten Modellmessungen vortäuschen.
original; geplant, keine Messdaten und kein gebautes Produkt
Ollama · 2026 · Abruf 2026-10-19
Kontextgröße in der App einstellbar; größere Kontexte benötigen mehr Speicher.
official; Markdown geprüft
https://docs.ollama.com/context-length
Ollama · 2026 · Abruf 2026-10-19
Parameter unter anderem temperature und num_ctx über Modelfile konfigurierbar; konkrete Modellunterstützung testen.
official; Markdown geprüft
https://docs.ollama.com/modelfile
Ollama · 2026 · Abruf 2026-10-19
Externer Websuchdienst; API-Zugang mit Ollama-Konto und API-Key. Zugangsdaten nie öffentlich einbetten.
official; HTML und Markdown geprüft
https://docs.ollama.com/capabilities/web-search
Ollama · 2026 · Abruf 2026-10-19
Cloudmodelle benötigen keinen Modelldownload; Anmeldung/Zugangsbedingungen beachten. Cloud verarbeitet Anfragen extern.
official; HTML geprüft
https://docs.ollama.com/cloud
Artificial Analysis · 2026 · Abruf 2026-10-19
Hardware-/Inferenzvergleich über wiedergegebene Agententrajektorien; nicht gleichzusetzen mit fachlichem Agenten-Erfolg oder eigenem HITL-Test.
primary benchmark publisher; Methodik geprüft
https://artificialanalysis.ai/articles/aa-agentperf-local/
Artificial Analysis · 2026 · Abruf 2026-10-19
Orientierung zu dokumentierten Hardware-/Modellkombinationen; keine pauschale Best-in-Class-Aussage für beliebige Studierendenhardware.
primary benchmark publisher; Seite geöffnet; dynamische Ergebnisse vor Vorlesung erneut prüfen
https://artificialanalysis.ai/hardware-inference-stack/laptops-workstations
Nutzerbestand KI Literacy Basics · 2026 · Abruf 2026-10-19
Vom Nutzer bereitgestellte Referenzgrafik anatomie_prompt.jpg nach tatsächlicher visueller Prüfung unverändert übernommen. Keine neue Generierung behauptet.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
OpenAI · 2026 · Abruf 2026-10-19
Tokenizer ist modell-/Encoding-abhängig. Lokale Pseudo-IDs sind frei erfunden und ausdrücklich keine OpenAI-Token-IDs.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://platform.openai.com/tokenizer
Google · 2026 · Abruf 2026-10-19
Gemini ohne AI-Abo: 32k, AI Plus: 128k, AI Pro/Ultra: 1M Tokens. Tarif- und produktabhängig; kein universeller Modellwert.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://support.google.com/gemini/answer/16275805?hl=en
OpenAI · 2026 · Abruf 2026-10-19
1.050.000 Tokens API-Kontext; nicht mit einem garantierten ChatGPT- oder Codex-Produktlimit gleichsetzen.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://developers.openai.com/api/docs/models/gpt-6.1-sol
OpenAI · 2026 · Abruf 2026-10-19
model_context_window und Kompaktierung hängen von Modell/Konfiguration ab; aktuelle Laufzeitanzeige beachten. API-Modellmaximum nicht automatisch aktives Harness-Fenster.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://learn.chatgpt.com/docs/config-file/config-reference
OpenAI · 2026 · Abruf 2026-10-19
Aktuelle ChatGPT-Hilfe bestätigt Modell-/Tarifabhängigkeit, nennt aber im geprüften Artikel keine allgemeine numerische Chat-Kontextgrenze. Keine erfundene einheitliche Grenze.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
Tesla / eigene reproduzierbare Messung · 2026 · Abruf 2026-10-19
139 PDF-Seiten. Eigene pageweise Textmessung mit PyPDF/o200k_base: 146.585 Tokens, Ø 1.054,57/Seite. Ohne Bilder/OCR; nicht ChatGPT-Ingestionsmessung.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://ir.tesla.com/_flysystem/s3/sec/000162828026003952/tsla-20251231-gen.pdf
Carlsen · 2026 · Abruf 2026-10-19
Carlsen nennt 336 Seiten für Band 1. Tokenbedarf nur Modellrechnung mit offengelegter angenommener Textdichte, kein vermessener Buchvolltext.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://www.carlsen.de/harry-potter/faq
OpenAI · 2026 · Abruf 2026-10-19
Klarer Auftrag und passende Beispiele. Zero-shot: kein Beispiel, One-shot: ein Beispiel, Few-shot: mehrere Beispiele; Multi-shot wird hier nicht als zusätzliche eigene Methode verkauft.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://developers.openai.com/api/docs/guides/prompt-engineering
MDN · 2026 · Abruf 2026-10-19
Manifest, passende Icons, HTTPS/localhost und browser-/plattformabhängiger Installationsweg. Service Worker für die hier zugesagte Offlinefunktion; file:// ist kein PWA-Installationsweg.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://developer.mozilla.org/en-US/docs/Web/Progressive_web_apps/Guides/Making_PWAs_installable
MDN · 2026 · Abruf 2026-10-19
Offline-Cache wird nach erfolgreichem Erstladen aufgebaut. Speicher kann geräumt werden; Offlinefunktion und Updates tatsächlich testen.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://developer.mozilla.org/en-US/docs/Web/Progressive_web_apps/Guides/Offline_and_background_operation
GitHub · 2026 · Abruf 2026-10-19
Kontoregistrierung und Anmeldung durch Menschen, Repo-/Sichtbarkeitsfreigabe ausdrücklich, Pages als statisches Hosting. Kein API-Key oder produktiver Datensatz in öffentliche Dateien.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://docs.github.com/en/pages/getting-started-with-github-pages/creating-a-github-pages-site
OpenAI · 2026 · Abruf 2026-10-19
Beispiel für lokal ausführbare offene Gewichte; Hardware-/Quantisierungsbedarf, Toolunterstützung und Lizenz konkret prüfen. Offene Gewichte sind nicht automatisch vollständig offener Trainingsprozess.
Primärquelle am 19.10.2026 geöffnet; Grenzen im Quellenanhang
https://developers.openai.com/cookbook/articles/gpt-oss/run-locally-ollama
Kie.ai / Nano Banana 2 nach Kursauftrag · 2026 · Abruf 2026-10-19
Symbolische Anschauung, keine empirische Modellmessung.
Tatsächlich generierte Bilddateien; Provider und Prompts im Medienmanifest
Artificial Analysis · 2026 · Abruf 2026-10-19
Gewichtung Intelligence/Speed/Cost, Anforderungen und agentische Fähigkeiten; Hardwarepassung zusätzlich prüfen.
Webseite und Auswahlstufen im Browser am 19.10.2026 geprüft; dynamisch, keine eingefrorene Siegerliste
https://artificialanalysis.ai/models/recommend
85–88 Startcheck · 88–94 Newsflash · 94–102 Lernwerkstatt/Fußballtafel · 102–110 eigene Ergebnisse. Danach 110–120 GitHub/Pages/PWA. Bei Setup-Problemen News kürzen. Pause nur als Moderationsfenster, keine Folie.